AI 通过视频图灵测试:一分钟通话,48% 的人以为对面是真人
视频接通的那一秒,你大概会先看三样东西:脸在不动的时候自不自然,说话时嘴型对不对得上,你停下来的时候,对面会不会抢话。十年里我们习惯了用这套本能给「对面是不是真人」做安检,而且几乎从不失手。10 月 1 日,旧金山的 AI 公司 Tavus 发布了一个叫 Griffin 的实时视频模型,把这套安检第一次打穿了:在一分钟的视频通话里,48% 的人相信对面坐着的是真人(Tavus 官方研究页)。
测试是怎么做的
规则说起来简单。54 名来自美国和欧洲的参与者,被提前告知自己将和「另一位参与者」视频连线,聊的话题是新的一年有什么期待;没人提醒他们对面可能是 AI(Pivot News)。一分钟后挂断,只问一个问题:你觉得刚才那个人是真人吗?26 个人说是。
作为对照,Tavus 上一代系统在同样的流程下,41 个人里只有 1 个认错,比例 2.4%。从 2.4% 到 48%,同样的公司、同样的考题,成绩翻了 20 倍。
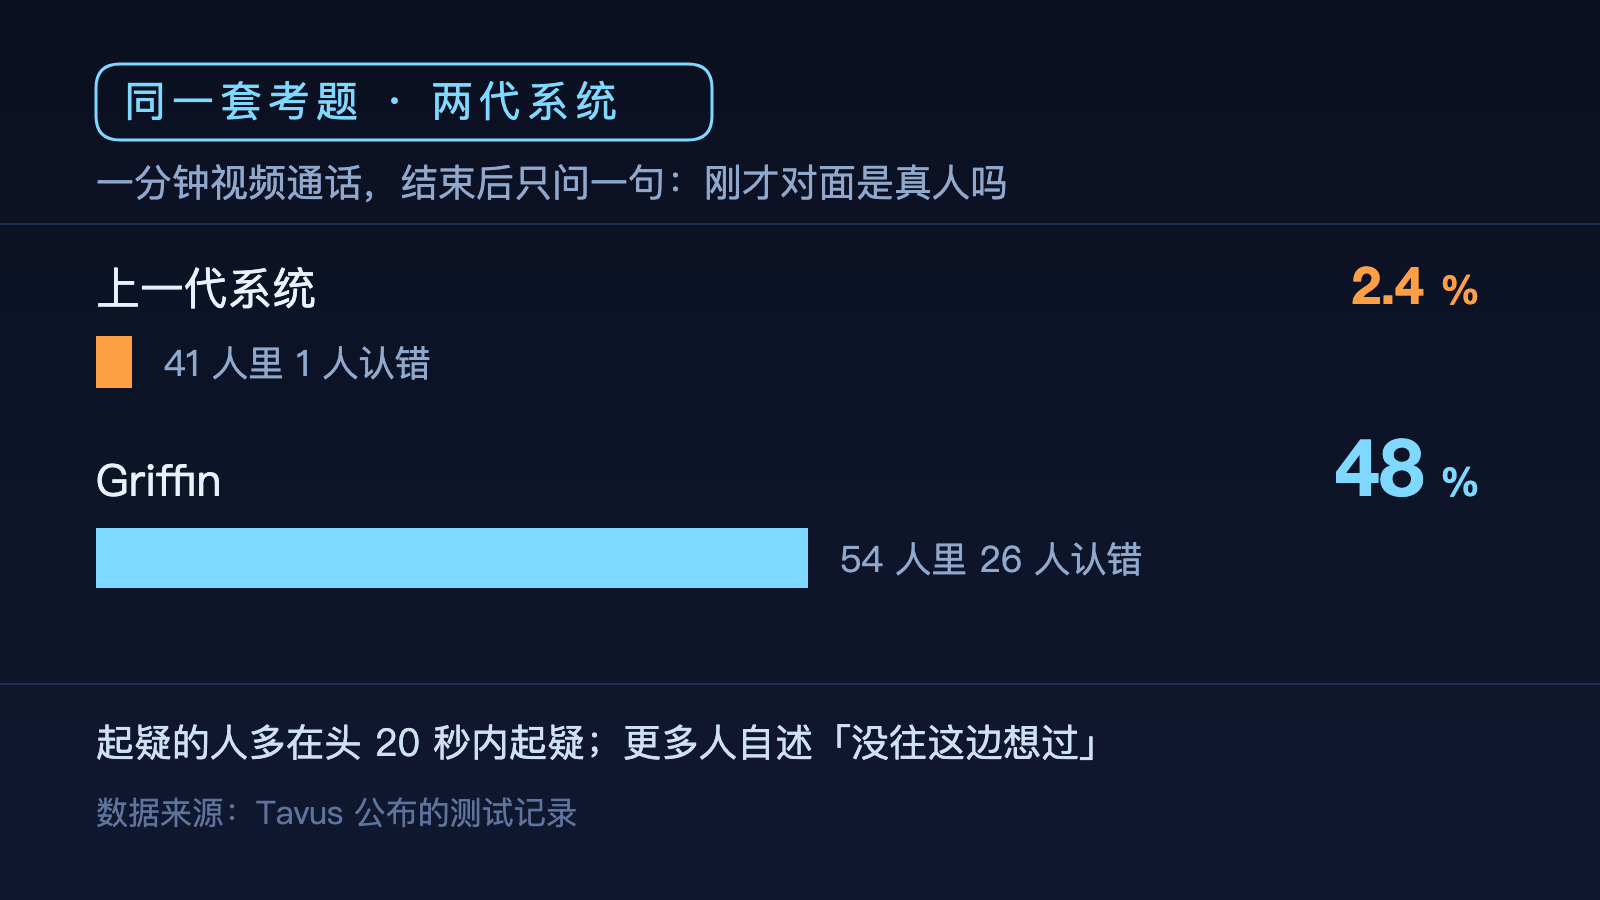
起疑的人,几乎都是在头 20 秒内起疑的;而超过一半的参与者说,通话过程中他们压根没往「对面可能不是人」这边想过。换句话说,被「骗」过的那 48%,多数不是识别失败的人,而是根本没启动识别的人。
它为什么突然像人了
过去几年你见过的「AI 数字人」卡在同一个地方:不像人不会说话,而像人不会接话。你停下来组织语言,它立刻抢答;你讲一件难过的事,屏幕上的脸还挂着笑。根子在架构上——传统的方案是一条流水线:先把你说的话转成文字,语言模型生成回复,再合成语音,最后驱动一张脸。每一道交接都加延迟,也丢信息:你的语气、你的表情、你举到镜头前的魔方,全在交接中扔掉了(网易科技对这场演示的描述)。
Griffin 把这条流水线压成了一个模型:一边听、一边看、一边说,全双工同时进行。它在说话途中持续读你的表情和停顿,被打断会停下来,你沉默思考时它就安静等着。音频到画面的延迟平均 0.43 秒,大约是同类系统的一半(腾讯新闻)。在英伟达的独立基准 VideoFDB 上,它的「像人程度」拿了 3.83 分(满分 5),人类参考值是 3.92,而上一个最好的 AI 只有 2.80——这组分数由英伟达独立评出,是 48% 之外少数不经 Tavus 之手的证据。
这个 48% 应该怎么读
先泼半盆冷水:这项测试是 Tavus 自己做的,54 人样本,没有设真人对照组,也没有按标准协议执行——发布当天,X 平台上的社区注释就把这两点标了出来,前文那份 Pivot News 的报道转述了这则注释。它测出的是「没有防备的人在 60 秒内会不会怀疑」,不是「怀疑的人能不能识破」。面对一段可疑视频,很多识别技巧——让对方转头、抬手、按脸颊——在这类端到端生成的模型面前正在失效,因为脸和动作本来就是它自己画出来的,不存在贴上去对不齐的问题。
但另一半冷水要泼给「眼见为实」本身。这套系统的语音克隆,只需要10 秒的声音素材——同样出自开头那份研究页。脸能实时生成,声音十秒到手,剩下的只是把两者接到一起的工程问题。这也是为什么 Tavus 自己反而不敢公开发布它——Griffin-Lite 目前只对少数受信任的测试者开放,公司说它还需要配上「AI 自我标识」之类的安全机制,才敢谈上线,理由写得很直白:这样的拟真度可能被拿去在视频通话里冒充他人。
眼见为实这条防线,不是被攻破的,是被绕过去的——它从来没有让你看到需要怀疑的东西。
值得记下的还有一个管理动作:一家把「通过图灵测试」当卖点的公司,自己先踩了刹车。这比 48% 本身更能说明问题的位置——技术已经跑到前面,规则还在后面追。
放到自己身上,这件事眼下只有三种态度可选:
A. 信平台。等微信、Zoom 这类通话平台强制加「AI 在场」角标,在那之前照常视频,不为小概率事件改变习惯。
B. 立规矩。从今天起,凡是视频里谈钱的请求——转账、付款码、改收款账户——一律挂断后用原来存的号码打回去核实,视频画面本身不再作为凭证。
C. 备暗号。和家人约定只有彼此知道的问题或梗,涉及大事先对暗号再谈事,成本最低,也不依赖任何平台。
这篇就到这。有收获点个「赞」,想接着看就点个关注。