骁龙端侧跑 300 亿参数大模型:每秒 330 是读,每秒 28 才是写
今天凌晨的骁龙峰会上,高通发布了第六代骁龙 8 超级至尊版和至尊版两款旗舰芯片,台积电 2nm 工艺,CPU 主频首次突破 5GHz(IT之家)。但整场发布会里最值得玩味的数字,不是这些,而是这一句:端侧能跑 300 亿参数的大模型,预填充吞吐超过每秒 330 个 token。
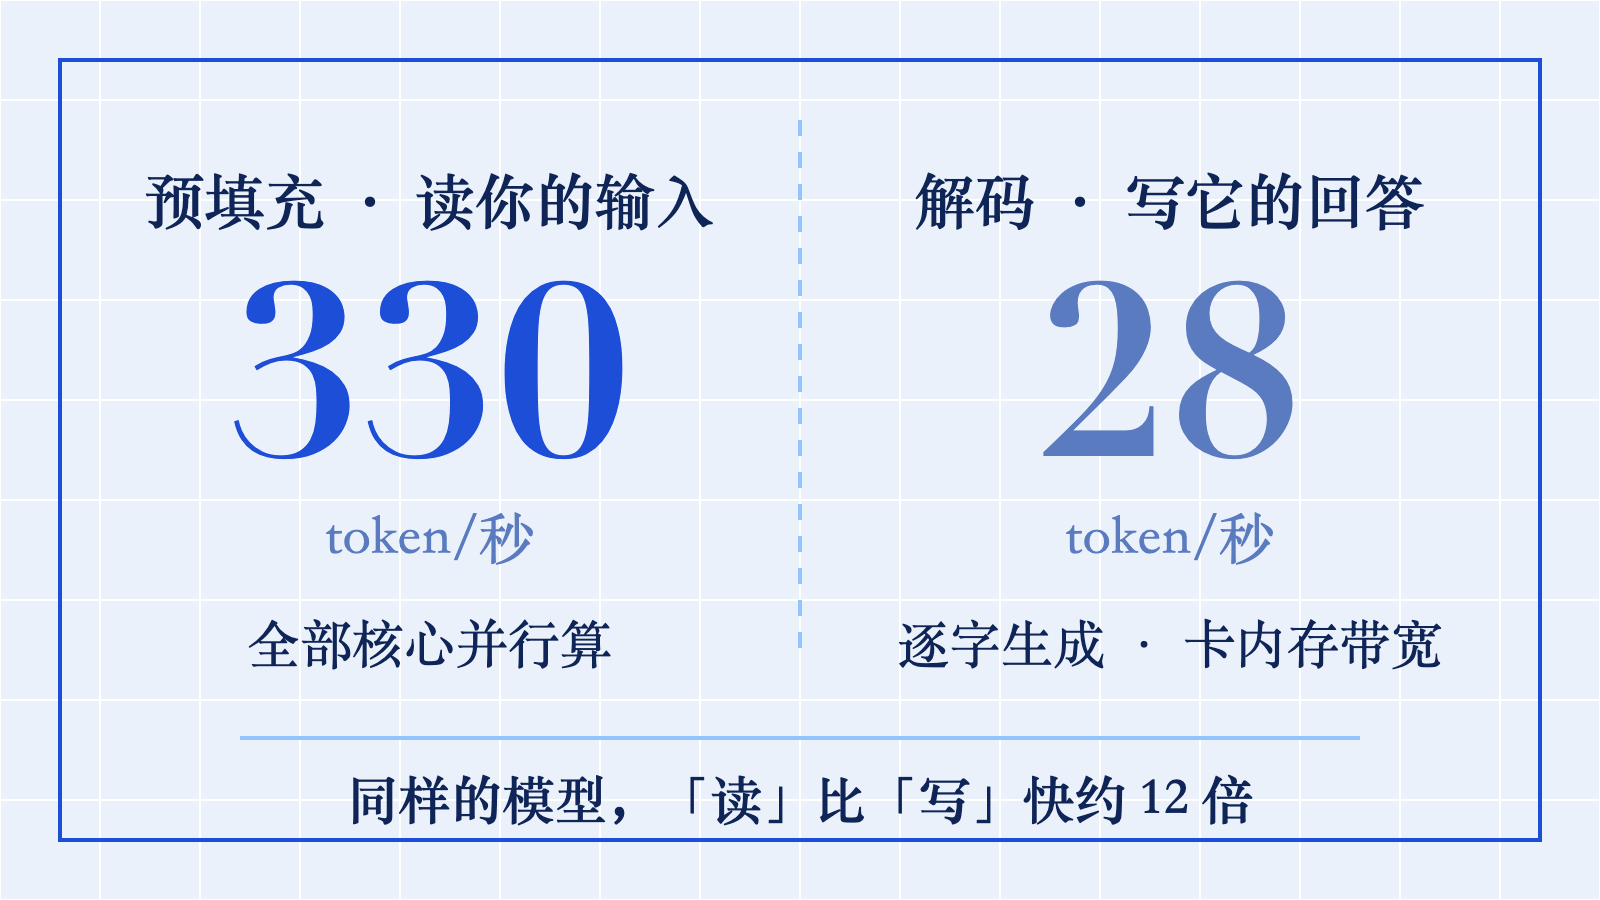
330,听着像手机一夜之间追平了云端。可你去翻高通和阶跃、无量火、江波龙联合演示的原始数据(IT之家),同一页上还印着一个低调得多的数字:解码吞吐,每秒 28 个 token。
330 是「读」,28 是「写」。差了 12 倍的两个数,说的根本不是同一件事。
330 是怎么读出来的
你给 AI 助手发一段话,它在回答之前要先把你写的东西全部读一遍——理解上下文、建立字与字之间的关联。这个阶段叫预填充(prefill)。它的特点是可以并行:一万个字一起算,芯片的所有核心一拥而上,所以吞吐量可以做得非常大。演示方案实测超过 330 token/s,首字响应压到 1.5 秒以内。
现场跑的是阶跃的 StepEdge-Omni 30B-MoE 模型,300 亿参数、混合专家架构。配合无量火的推理引擎和江波龙的存储优化,运行内存需求比行业常规方案低了一半以上,全程不连云端,离线完成读邮件、排行程、写回复草稿(IT之家)。
每秒 28,才是你等的那个数字
读完了,模型开始一个字一个字往外写。这个阶段叫解码(decode),它没法并行——第 100 个字依赖前 99 个字算完的结果,每生成一个 token,模型参数和中间数据都要在内存和处理器之间来回跑一趟。速度上限卡在内存带宽上,卡得死死的。
每秒 28 个 token,按中文大约 1 个 token 折 1.5 个字粗估,就是每秒 40 个字上下。回答一句 100 字的问题要两三秒,写一段 400 字的长回复得等 10 秒左右——够用,但和「追平云端」完全是两个体感。云端大模型的解码速度普遍是它的几倍到几十倍。
所以下次看到「每秒 330 token」,先问一句:是读,还是写?
300 亿参数是怎么塞进手机的
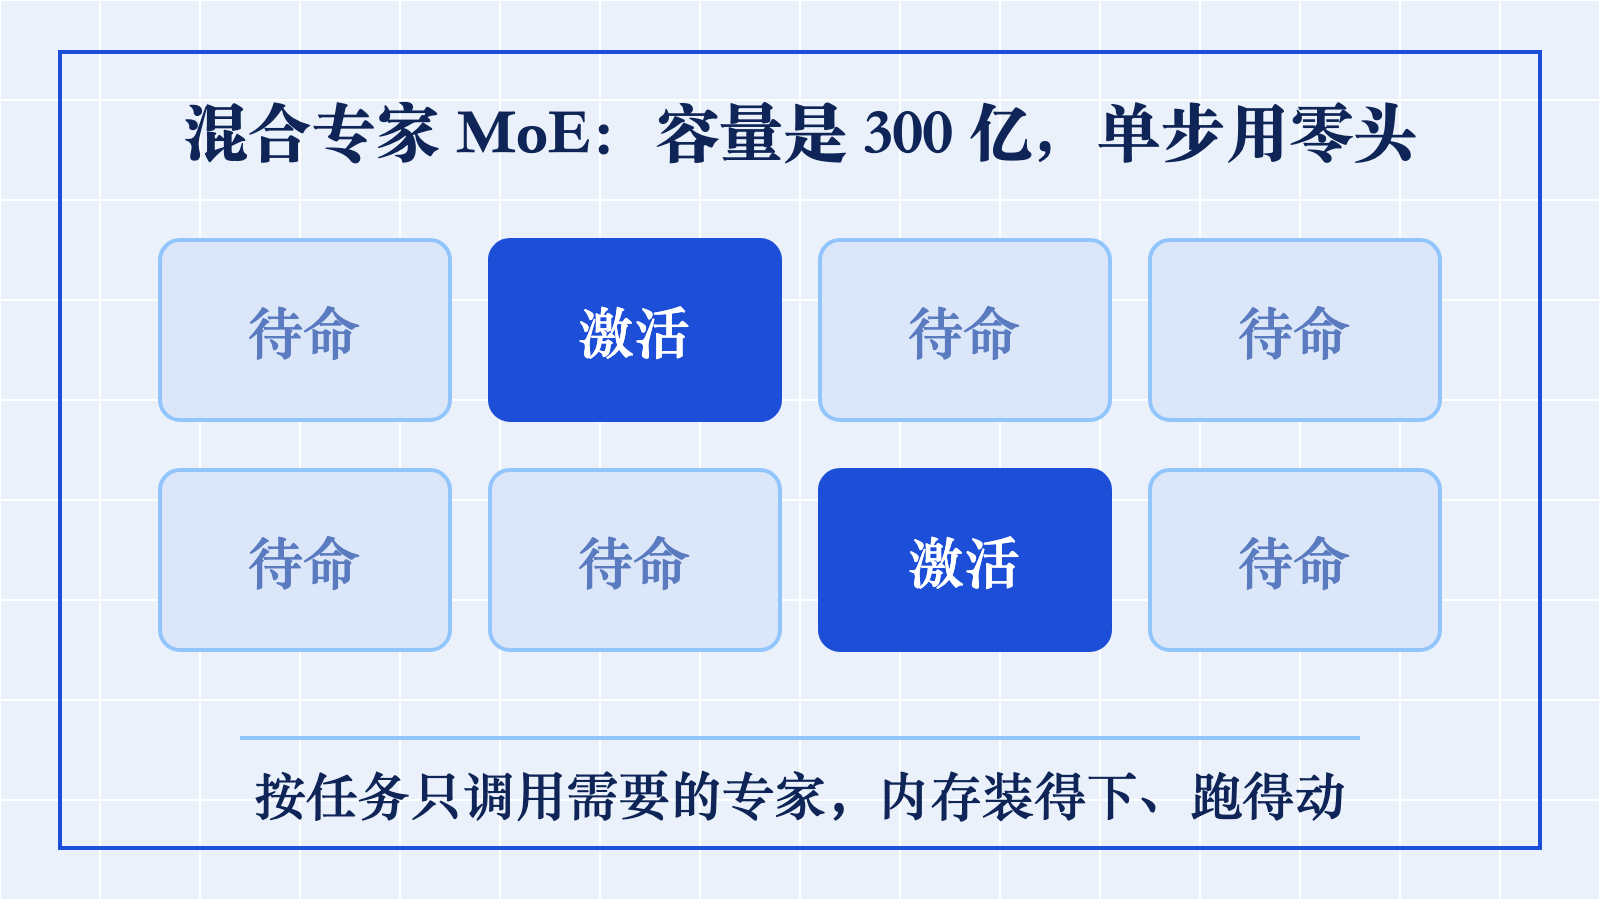
传统大模型每算一步都要动用全部参数,300 亿参数全参激活,手机内存根本装不下。MoE(混合专家)架构的思路是把模型拆成一群「专家」,每次只按任务激活其中一小部分——容量是 300 亿,单步消耗只有零头。
再叠加两层优化:无量火 Ember 引擎把内存占用压掉一半以上;江波龙的存算协同让模型权重从闪存按需加载,不必整块常驻内存。三件事凑齐,300 亿参数才在手机上跑了起来。
真正的瓶颈不在算力,在搬运
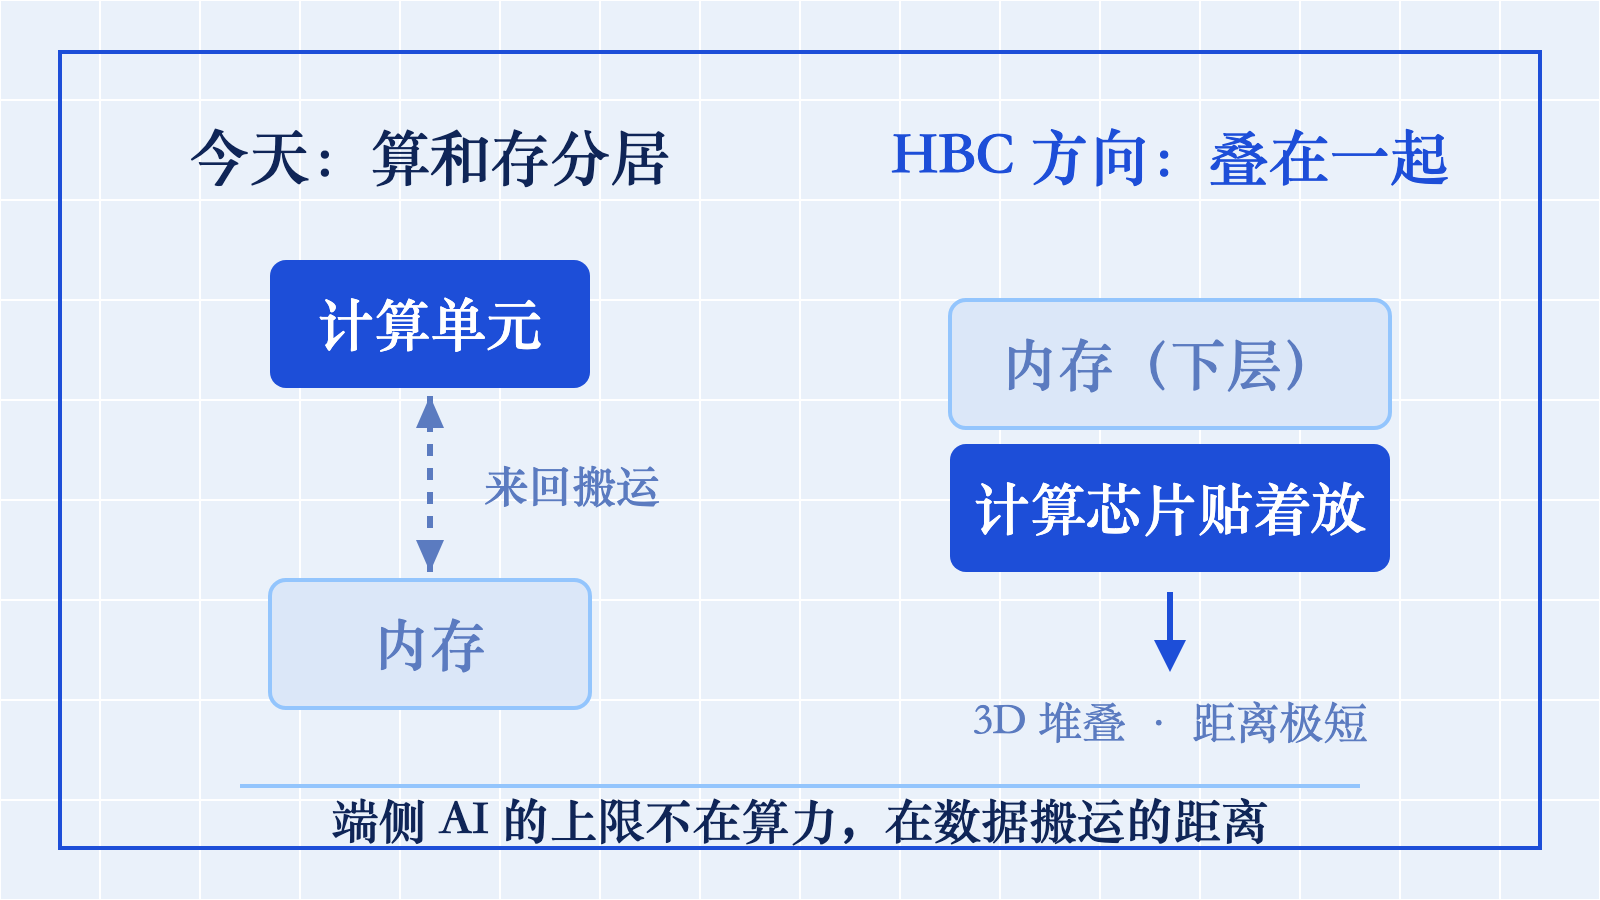
这次峰会上还有一条容易被忽略的消息:高通宣布,把原本给数据中心设计的高带宽计算架构 HBC 下放到骁龙——把计算芯片直接叠在堆叠内存正下方,缩短数据搬运的距离(新浪科技)。
为什么执着于「搬得近」?因为端侧 AI 最大的天花板已经不是芯片算力,而是数据在内存和处理器之间的搬运速度——也就是业内说的「内存墙」。解码为什么只有 28?答案就堵在这堵墙上。注意 HBC 目前是预告,本代芯片还用不上,但它指的方向很明确:谁的内存离算得近,谁跑大模型就快。
年底买旗舰,学会问三个问题
接下来几个月是安卓旗舰季,这类数字会一轮接一轮地刷屏。看之前先过三道闸:
第一,问是「读」还是「写」——预填充数字天生大,体验由解码决定。
第二,问是峰值还是稳定值——演示机、特定模型、理想散热,量产机打几分折扣没人替你保证。
第三,问是定制方案还是标配——这次的 330 和 28,是高通联合三家伙伴针对一款模型调出来的,你买到的手机不一定带着这套优化。
我的判断放在这:28 token/s 对日常问答已经够用,真正决定端侧 AI 体验的是内存容量——不管架构怎么演进,模型住的地方永远是内存。所以为 AI 换机时,与其追芯片名字里的「超级」,不如看看那台手机的内存给没给足。
先这样,回头见。点个「赞」让我知道你来过,还没关注的话顺手点一个。