谷歌新旗舰把价格砍到五分之一,但榜单上有个小字:High 档
时隔近一年,谷歌终于交出新旗舰:Gemini 4 Argon 本周起面向全球开发者、企业和付费订阅用户陆续开放。这是谷歌自 Gemini 3 之后第一个真正意义上的前沿模型——这一年多里,第一梯队的位置被 OpenAI 和 Anthropic 轮流占着,谷歌一度被质疑掉队。早在 9 月 30 日它就宣布过首批限量,之后是一连串「下周见」,这次总算全量放量。现在它回来了,姿态还挺凶:性能对标对手,价格直接砍半再砍半,一份 217 页的安全报告陪着一起发布。
五折是真的,但有时限
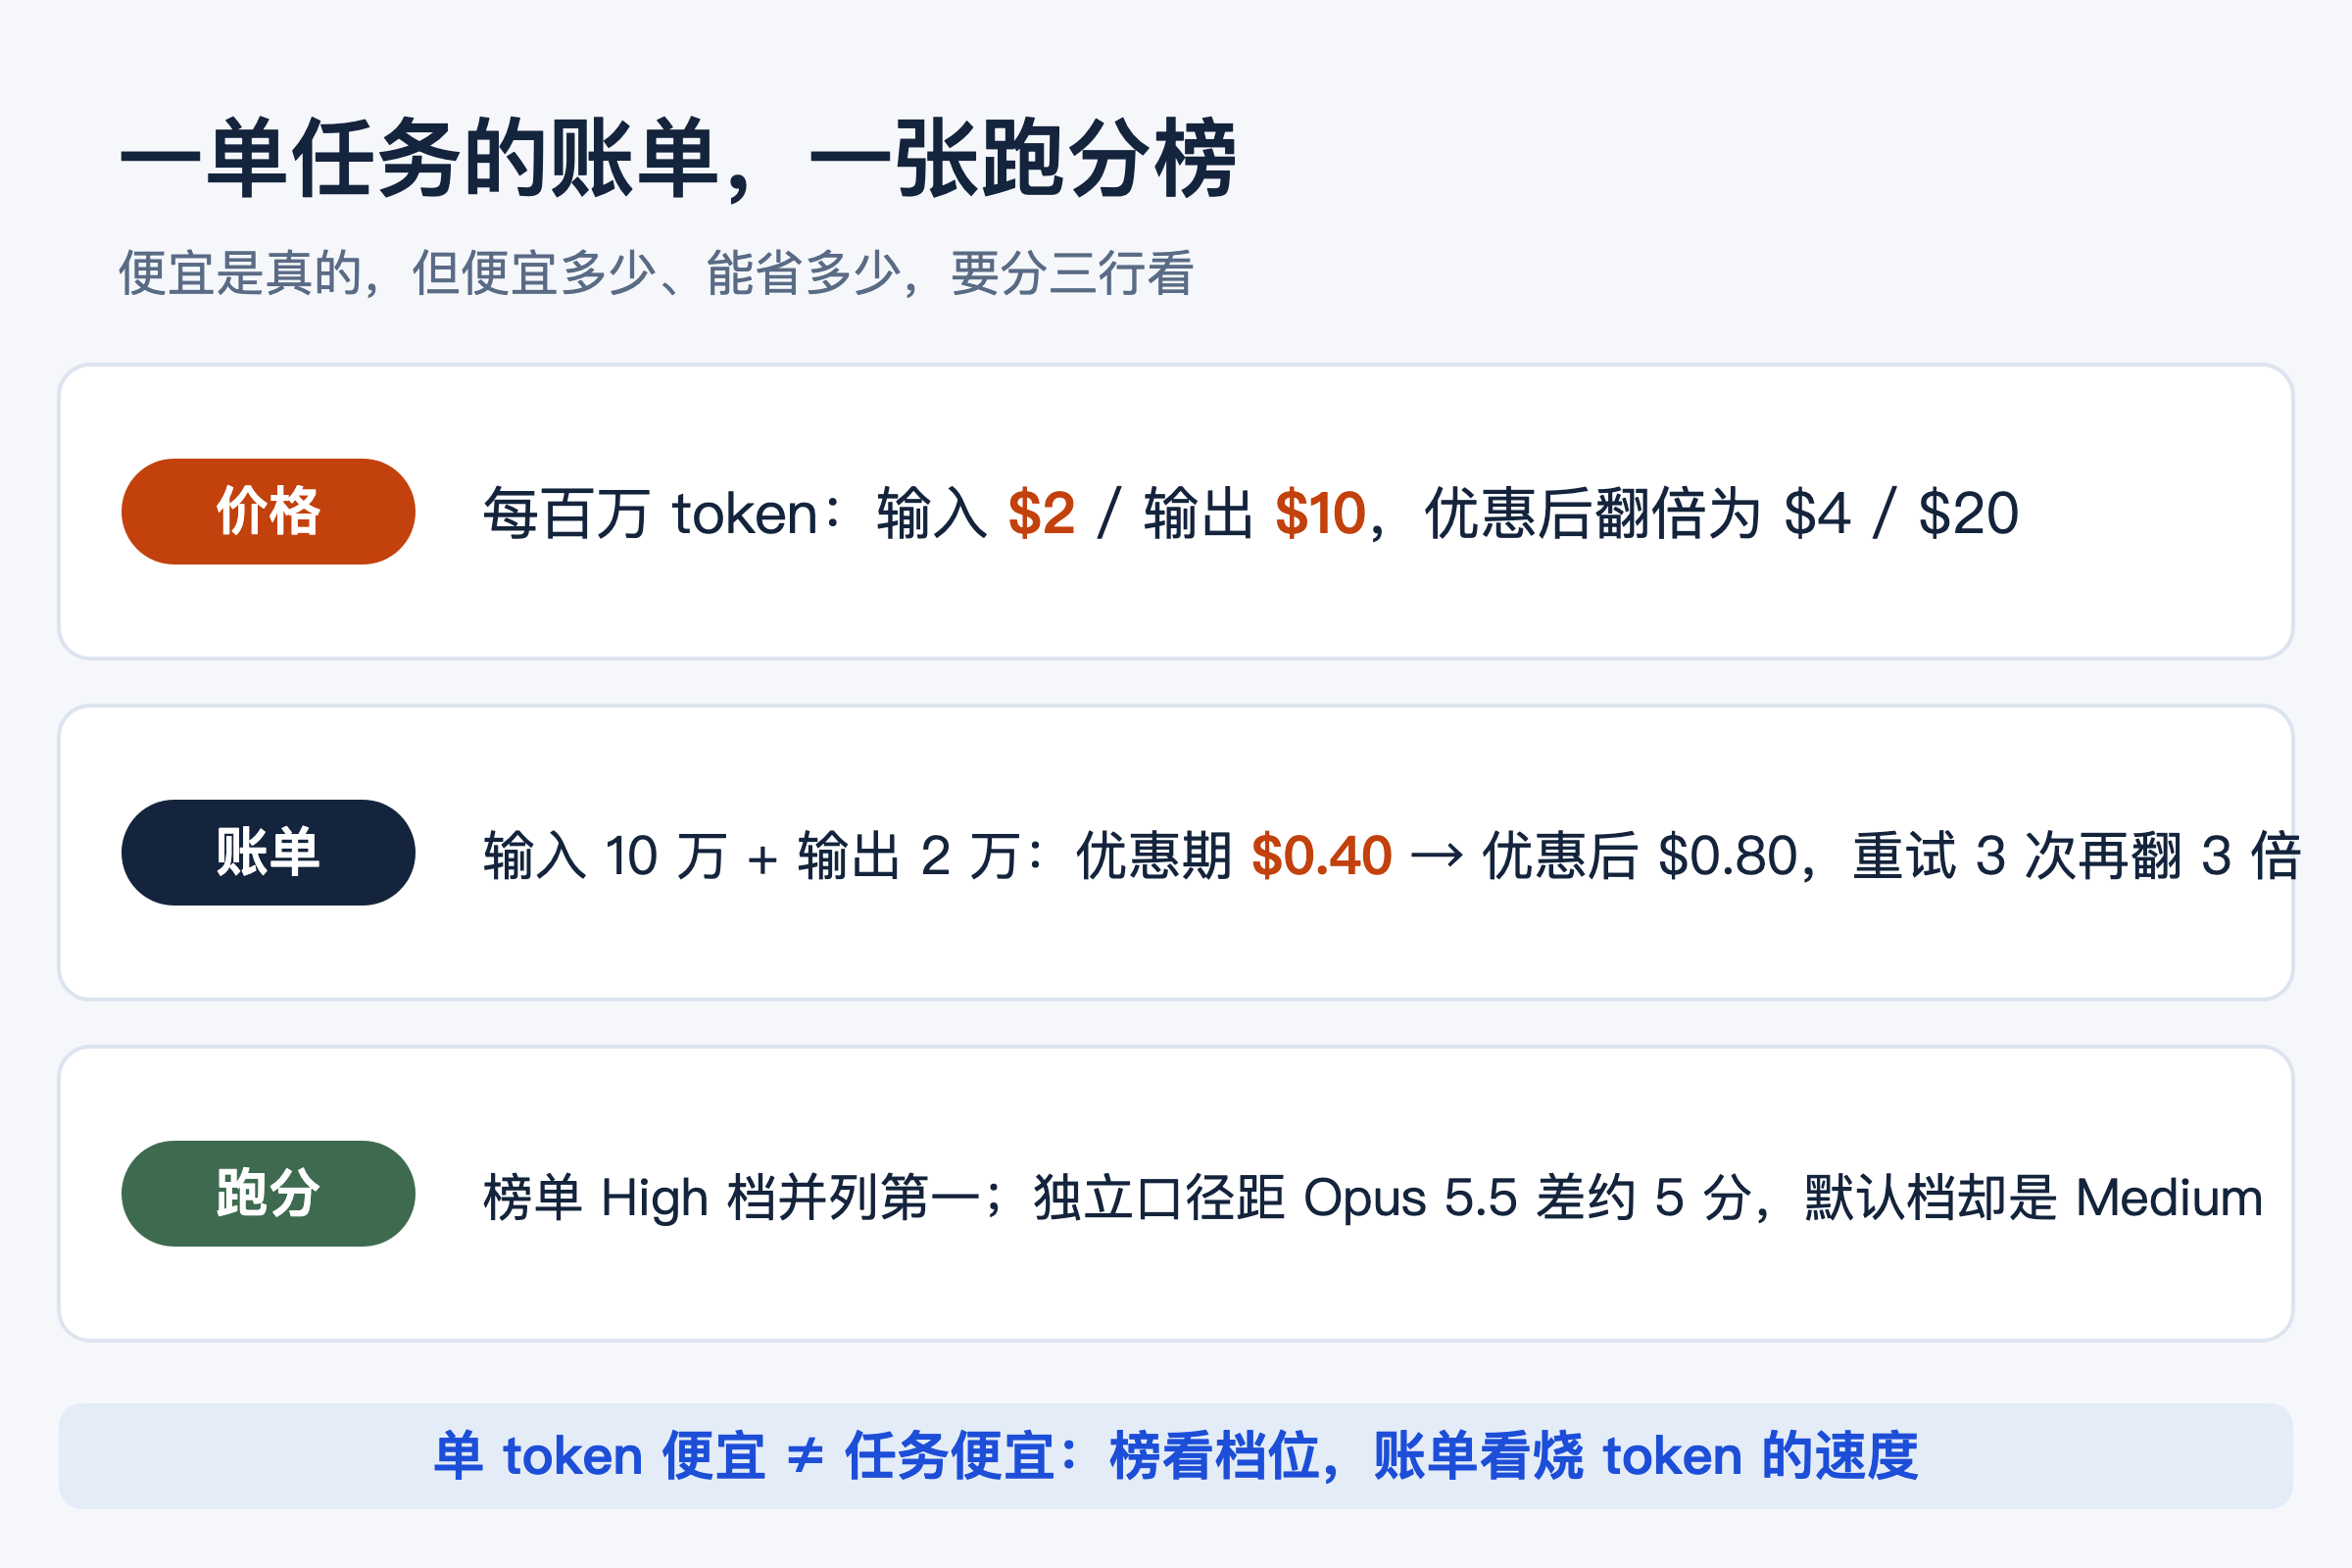
API 首发价是每百万 token 输入 2 美元、输出 10 美元,约为 Claude Opus 5.5 的一半、GPT-6 Astra 的五分之一。先泼半盆冷水:这是优惠价,12 月 1 日起恢复为 4 美元和 20 美元,折扣期就这两个多月。
把账摊开算。正算一笔常见编程任务:输入 10 万 token、输出 2 万,优惠期花 0.4 美元,恢复原价后 0.8 美元。反算同一笔活:在 Astra 身上按五分之一的口径要花约 2 美元——价差最大的窗口,就是现在这两个月。对天天调 API 的开发者,这是官方主动降半价;谷歌自己也给了个更直观的口径:同一批任务,Argon High 平均每任务成本 1.99 美元,比 Astra 低约 39%。
榜单很好看,档位是小字
谷歌宣称 19 项基准测试里 13 项领先对手;第三方 Artificial Analysis 智能指数上,Argon High 拿到 53 分,与 GPT-6 Astra Max、Claude Fable 5.1 Max 并列。乍一看,第一梯队门票是拿到了。
但榜单有个小字:官方表格全部用 High 推理档测出,而模型默认档位是 Medium——多数订阅用户开箱即用的就是默认档。独立复测里,Argon High 52.56 分,距 Claude Opus 5.5 的 57.62 差着约 5 分;在考察终端操作的 Terminal-Bench 4.0 上,它也输给了 Opus 5.5。同一个模型,换一档推理强度,榜单名次能差出半个梯队,看榜时得把这一行字放大看。真正经得起复测的亮点是幻觉率:15%,是所有 45 分以上模型里最低的,同口径下 Astra 是 51%——对拿模型查资料、写报告的人来说,这比名次更实在。
单 token 便宜,不等于任务便宜
价格牌还有一层要拆:不同模型干同一件活,烧的 token 数不一样。模型不够聪明、一个任务来回重试,省下的单价差就全烧回去了。提前用上的早期体验者 Ethan Mollick 的评价比较中肯:相比上一代 Gemini 是明显跃升,写作和创造力有进步,但复杂多智能体任务仍有差距,偶尔过于自信、犯懒。
给你的判断:重度编程和自动化用户,这两个月的折扣价值得一试,跑完真实工作流再决定要不要把主力任务迁过去;Gemini 订阅用户在 App 和搜索的 AI 模式里已经能用。普通读者不用动——等 12 月恢复原价后看它的实际口碑,如果到时候用户流失得快,续命打折大概率还会来。
看完了?点个「赞」让我知道;还没关注的,点个关注就是最大的支持。