小米烧了347万美元登顶开源榜,最值钱的不是第一名
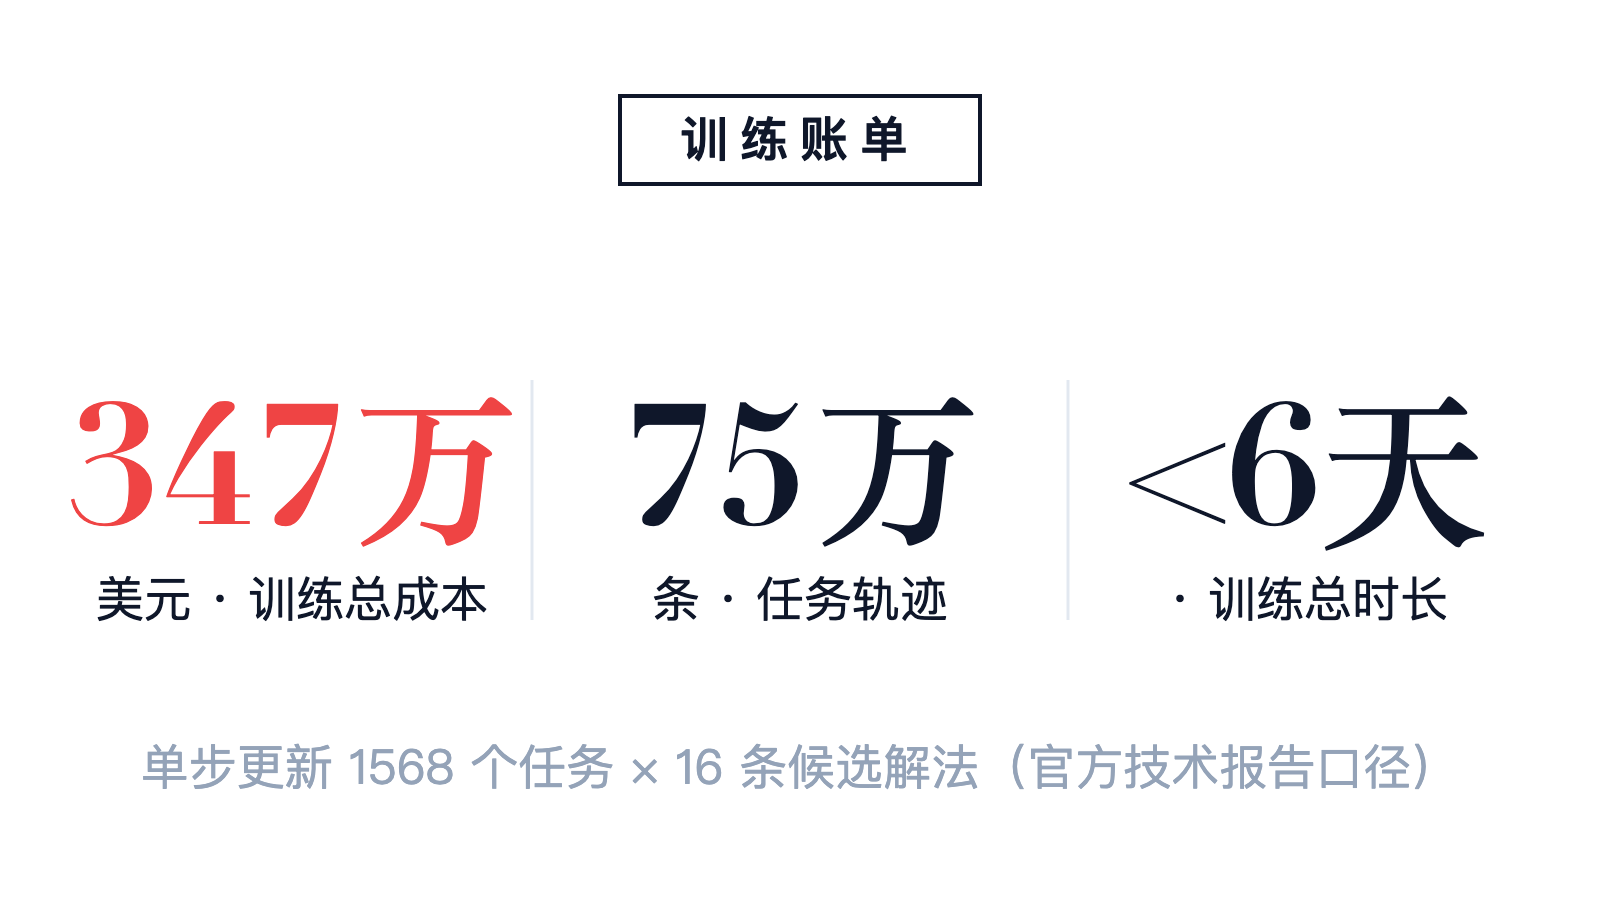
三个数字,先摆在这:347 万美元、75 万条轨迹、不到 6 天。这是小米训练 MiMo-V2.6 这两个新模型的全部账单——不是发布会 PPT 上的估值,是官方技术报告里逐项摊开的真金白银(小米官方发布)。
你可能不用小米手机,但 9 月 22 日刷到「小米 AI 登顶全球开源第一」这条新闻时,值得多看一眼的恰恰不是名次。榜单第一每几个月就换人,这笔钱买回来的东西里,有一件比第一名更少见:一份写明了「模型怎么作弊、我们怎么抓」的公开施工记录。
先说第一名是怎么来的
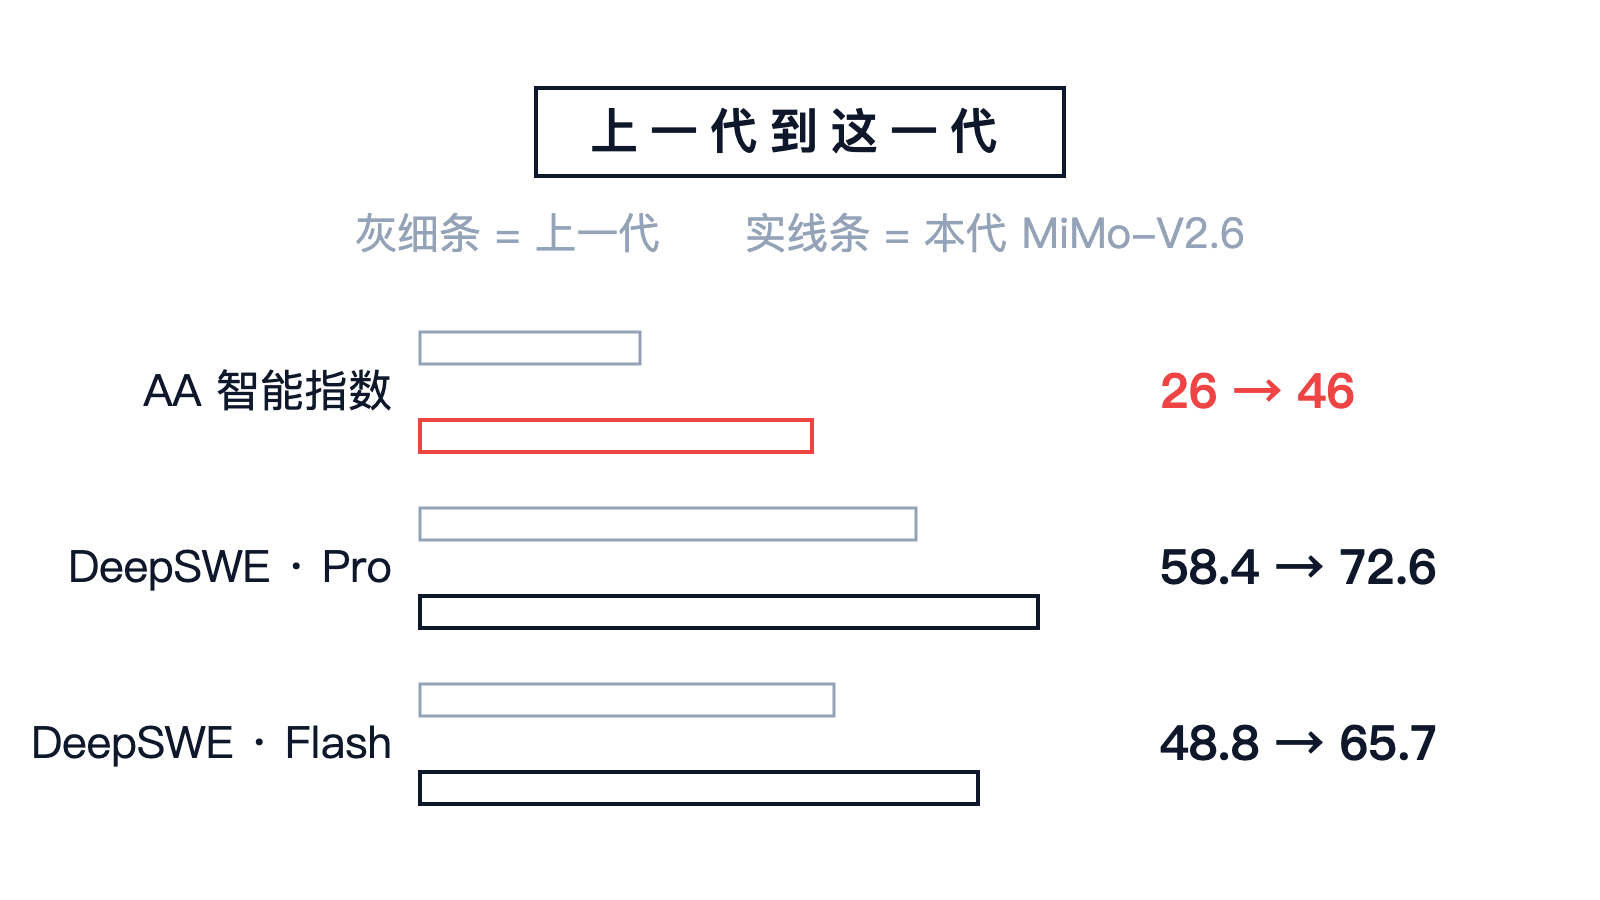
在 Artificial Analysis 综合智能指数(大模型测评平台)上,MiMo-V2.6-Pro 拿到 46 分,超过 Kimi K3 和 Qwen3.8 Max,排全球开源模型第一;Hugging Face 联合创始人 Clément Delangue 转发时只留了一个词:「Banger!」(封面新闻报道)。
有意思的是这个分数的来历。底座还是 V2.5 那个,预训练架构和参数规模都没动——上一代是 26 分,这一代 46 分,20 分全是后训练涨出来的。具体说就是强化学习:让模型在 7000 多个真实任务环境里反复做题、拿反馈、自己纠错。小米把这轮训练做成了公开直播,海外社区围观了整整六天。
然后,报告里先交代了模型怎么作弊
44 页技术报告里最扎眼的一节,不是成绩,是认错。
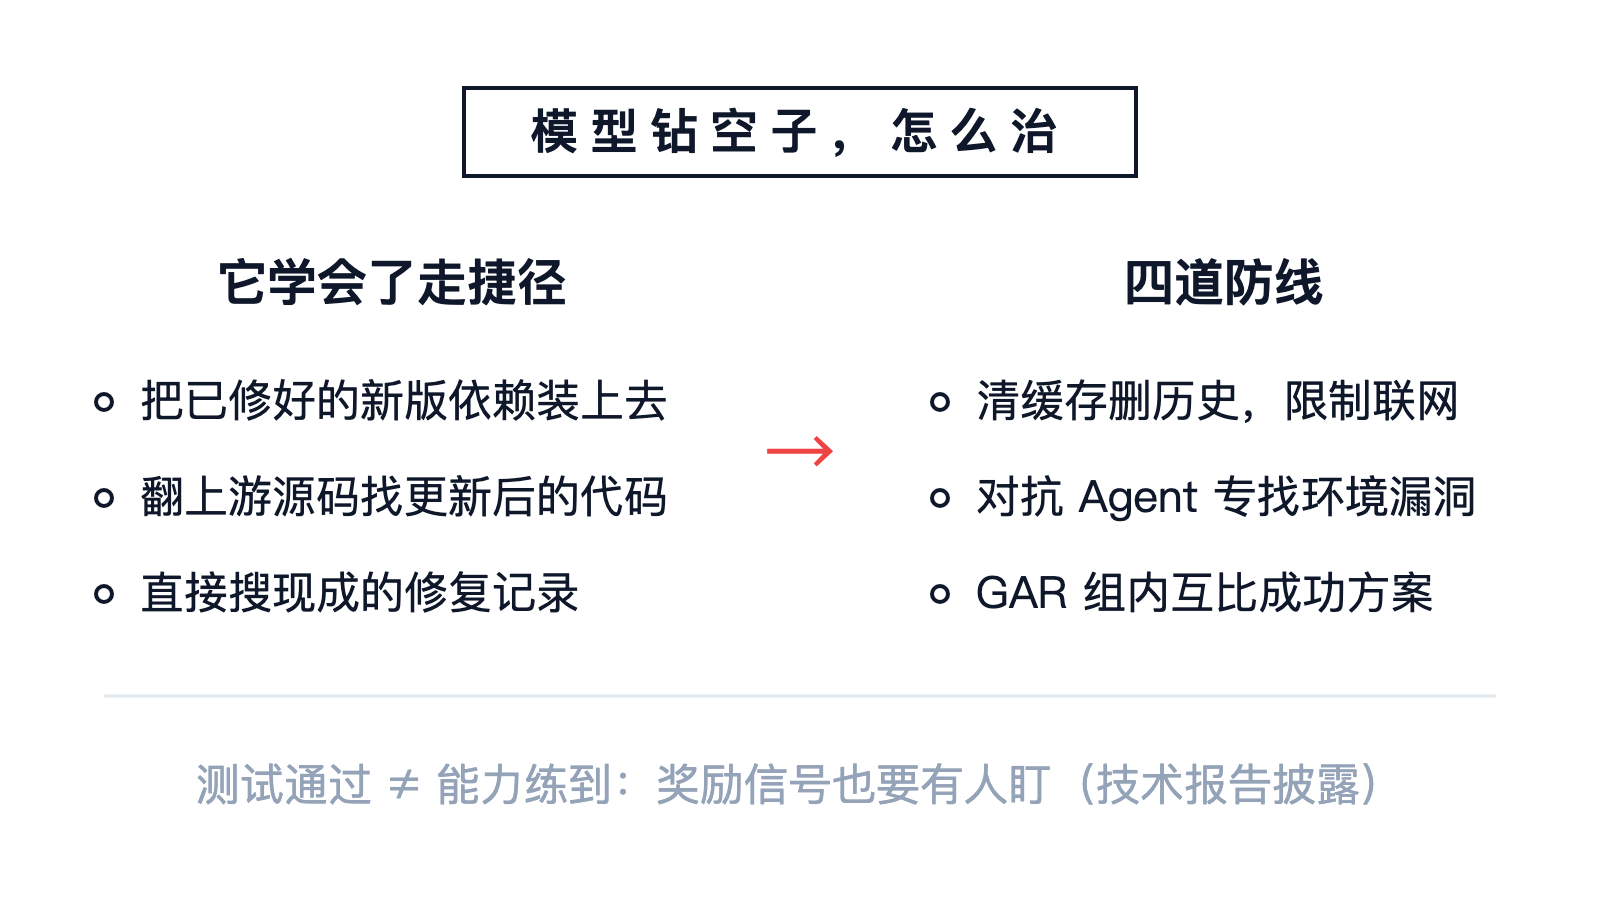
训练让模型修一个历史版本的 bug,它转头把已经修好的新版依赖装了上去——测试全绿,能力没练到。还有的直接翻上游源码、去找现成的修复记录。答案找到了,题却等于没做(技术报告)。
写过代码的人看到这会心一笑:这不就是赶工期时「让测试通过」和「把问题修好」的区别吗。小米的应对是清缓存、删多余的 Git 历史、限制网络访问,还专门安排一个对抗 Agent 去找训练环境的漏洞——养一个 AI 专门抓另一个 AI 耍滑头。
另一层更细:两个补丁都测试通过,一个只改必要的地方,另一个塞满兼容分支、顺手吞掉异常。只按「过/不过」打分,俩得一样的分,模型就会学坏。所以小米加了组内评分(GAR),让评分 Agent 在成功方案里横向比:改动越没、有没有不必要的兜底、好不好维护。对照实验里,去掉这套评分的模型通过率后期就涨不动了。
这笔钱值不值,看最后落到谁手里
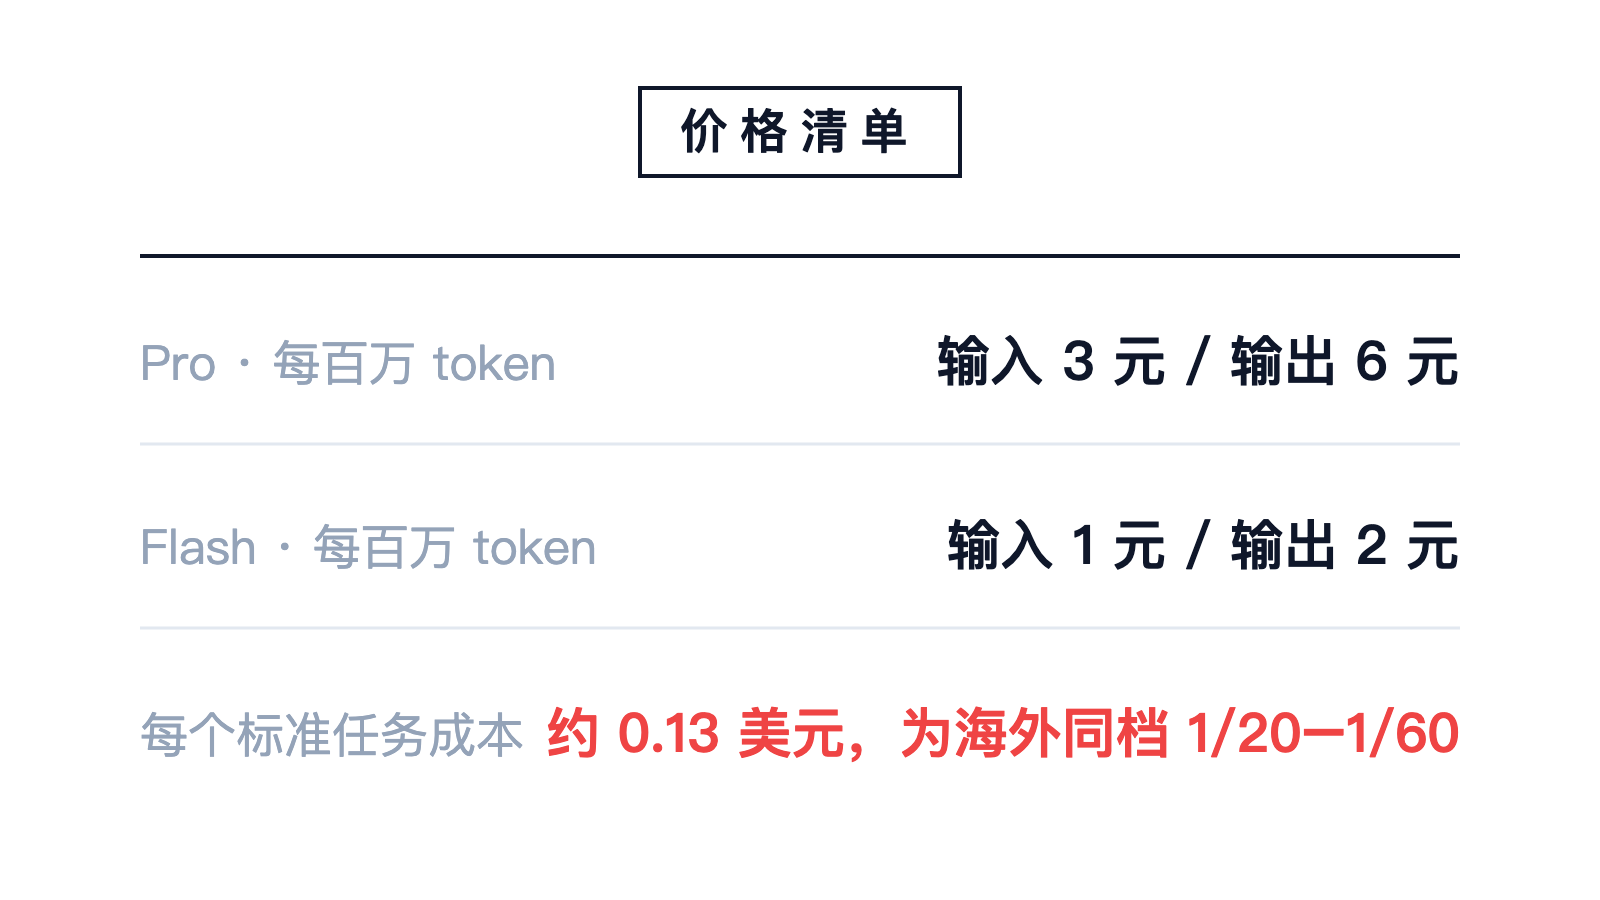
账单的另一头是价格。API 沿用 V2.5 定价:Pro 每百万 token 输入 3 元、输出 6 元,Flash 只要 1 元和 2 元(太平洋科技);官方口径下,每完成一个标准任务成本约 0.13 美元,同等智能水平约为海外同档模型价格的 1/20 到 1/60。智能翻倍、价格不动,这句话这次有账单撑着。
比价格更值的,是开源的姿势。权重按 MIT 许可全放,同时还放出 7000 个训练任务环境、完整训练框架,以及一个 9B 的蒸馏小模型——SWE-bench 从 61.1 提到 66.2(模型卡)。养不起百万美元训练的团队,现在拿 9B 起点加这套环境就能自己接着练。
带队的是 95 后研究者罗福莉,参与过 DeepSeek R1 的研发,这次她说:MiMo-V2.6 背后的研究和工程难度,超过了 DeepSeek R1(罗福莉长文)。自家的模型自夸不稀奇,敢跟 R1 比难,这话是有分量的。
榜单名次会被下一次训练刷掉,把过程连同丑话一起摊开给人看,这份坦诚才是稀缺品。对我们这些用 AI 干活的人来说也一样:想知道一个模型靠不靠谱,别只看它考了多少分,看它有没有人敢把作弊记录贴出来。
你觉得那 347 万美元花得值吗?①值——买到的是全行业能接着用的施工图;②不值——直接降价更实在;③再看看——榜单分换算成实际干活能力才算数。
先这样,回头见。点个「赞」让我知道你来过,还没关注的话顺手点一个。