OpenAI 用 88 小时解出 90 年数学难题,25 位菲尔兹奖得主联名抗议
一道困扰了数学界 90 年的题,被 1 万个 AI 用 88 小时解开了。按常理,这该是学术圈的头条喜事。但过去几天,数学界最响亮的声音不是祝贺——9 月 11 日,陶哲轩、邓煜等 25 位菲尔兹奖得主发布联合声明,警告「AI 公司正在摧毁数学」。
为什么答案解出来了,人反而先吵翻了?这件事值得从头讲一遍,因为它跟你兜里那个 AI 订阅有关。
88 小时,1300 亿 token,一道 90 年的题
先看 OpenAI 的时间线。
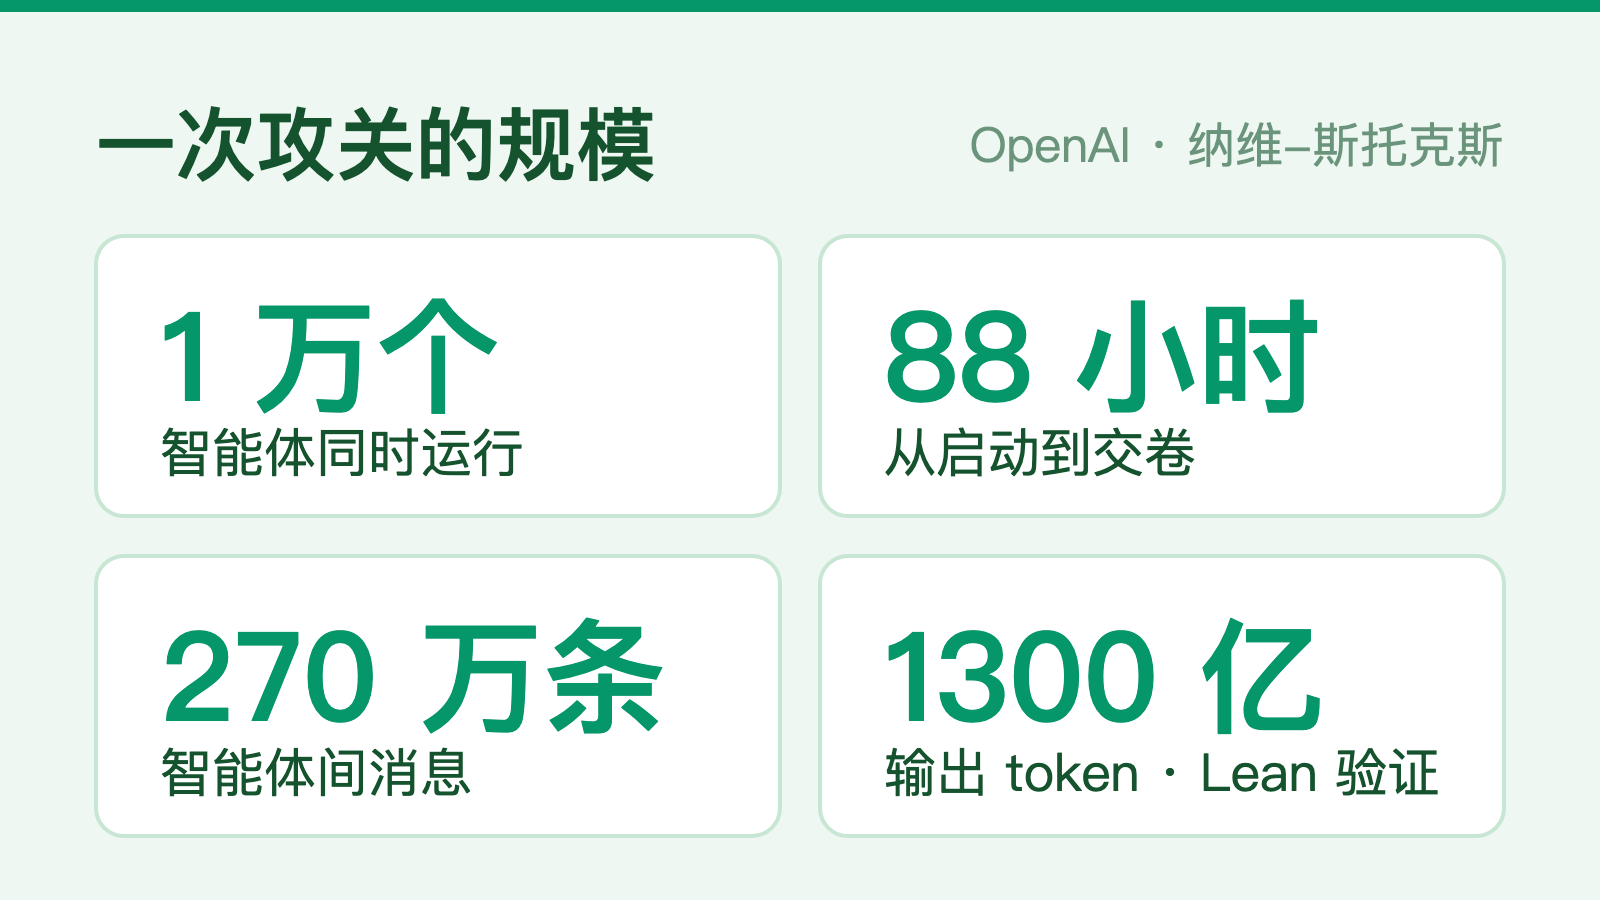
9 月 1 日,OpenAI 听到传闻说 Anthropic 已经解决了两个千禧年大奖难题,随即决定拿一个 8 月 28 日才开始训练的内部模型试一试。先是约 100 个 AI 程序跑了 50 小时,在无外力的欧拉方程上拿到结果;OpenAI 立刻把资源集中过去,最终同时运行约 1 万个智能体冲击升级版的问题——三维纳维-斯托克斯方程。
9 月 5 日,启动约 88 小时后,系统给出了一个反例:一个光滑的三维流体,可以在外力作用下发展出有限时间的奇点。整个过程产生了 270 万条智能体间消息、约 1300 亿输出 token,证明在 Lean 定理证明器里完成形式化验证,成稿 166 页。
纳维-斯托克斯方程描述流体运动,是克雷数学研究所悬赏 100 万美元的七大千禧年难题之一。有一个细节可以说明 OpenAI 自己对成果的定位:他们明确表示不申领这 100 万美元奖金。因为严格来说,他们的证明对应的是官方表述中带外力项的情形,而且证明尚未经学界独立复核,克雷研究所也未表态。
争议不在答案,在时间线
如果故事到这里为止,顶多算一次有争议的「抢答」。真正点燃数学圈的,是 9 月 8 日的事。
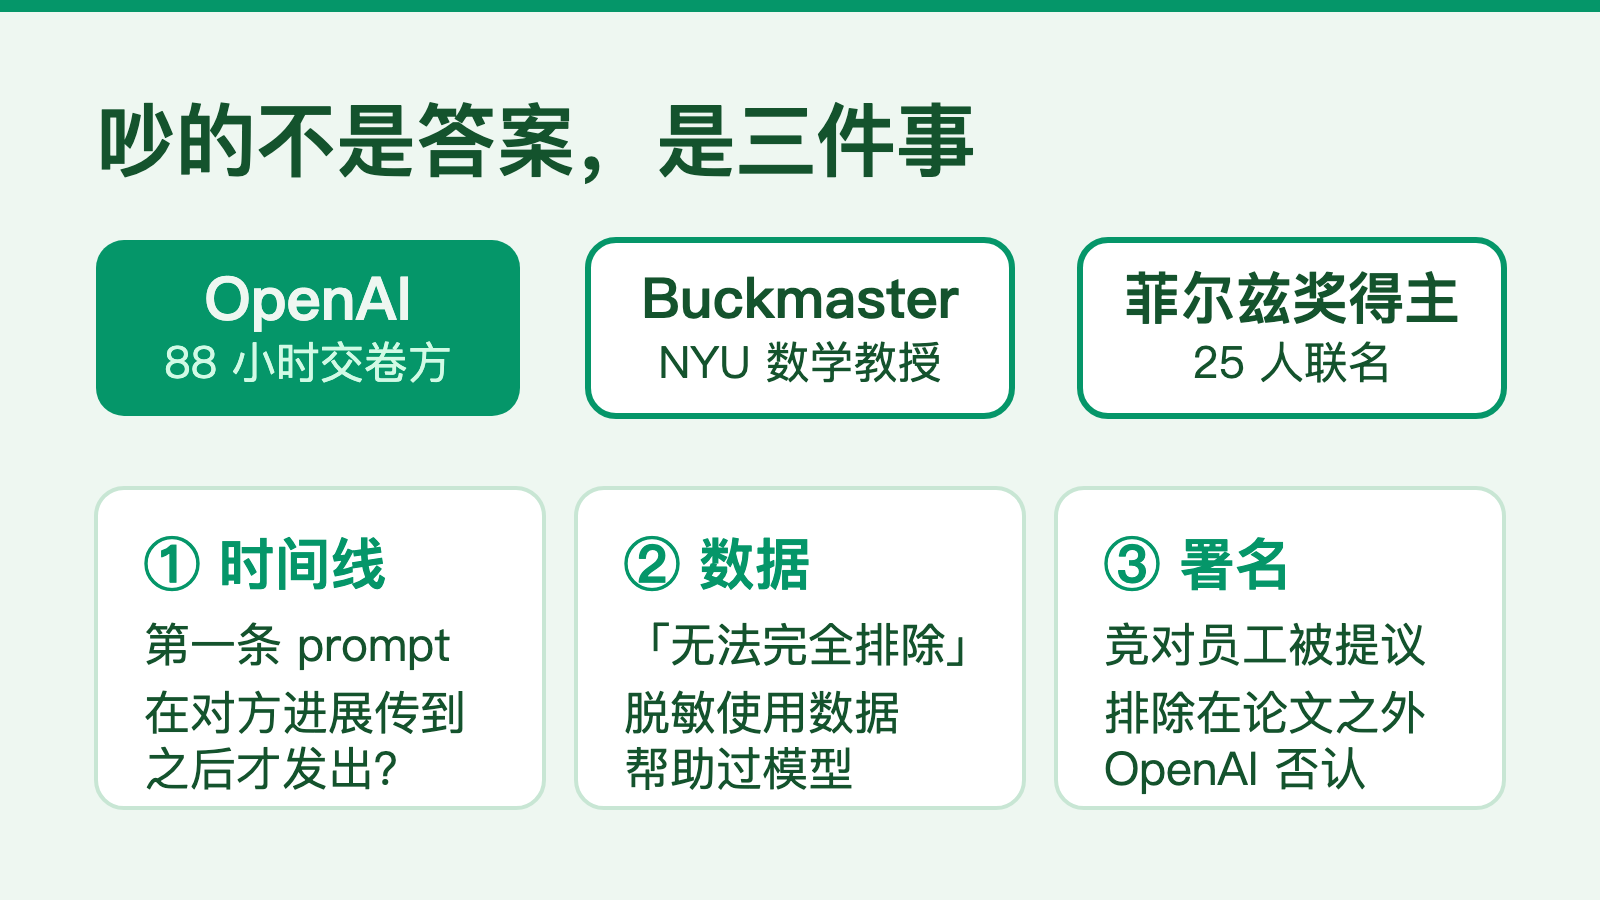
那天上午,纽约大学的 Tristan Buckmaster 和 Anthropic 研究员 Levent Alpöge 发布了他们在相关方程上研究近一年的成果——主要用 Codex 和 Claude 完成的。几个小时后,OpenAI 宣布解出了纳维-斯托克斯。
Buckmaster 的指控集中在一处:他和 Alpöge 的研究进展「已经传到了 OpenAI」,而 OpenAI 的第一条 prompt,正是在这个信息到达之后才发出的。他进一步指出,OpenAI 选择的技术路线与他们长期推进的方向高度重合,这不像是模型拿到题干就能几天内自己找到的路径。
OpenAI 全盘否认,称研究者和智能体在两人公开发布前没有以任何方式看到他们的工作。但同一份声明里有一句话,被截图传遍了整个数学圈:他们「无法完全排除」这两位数学家使用产品时留下的脱敏数据,曾经帮助模型改进。
更难看的场面在后面。Buckmaster 称,OpenAI 的 Sébastien Bubeck 曾提议让他参与基于 OpenAI 证明的论文,但不许 Alpöge 加入——理由是后者是竞对员工;他提出异议时,得到的回复是「你为什么要毁掉自己的职业生涯?」OpenAI 对这一说法有不同描述。Yann LeCun 转发时补了一刀,反讽 OpenAI「没放过任何一条好客户记录」。
25 位菲尔兹奖得主为什么坐不住
9 月 11 日,陶哲轩、邓煜等 25 位菲尔兹奖得主发布联合声明。声明的核心不是「AI 不能做数学」——恰恰相反,他们不否认这类成果的技术价值。他们担心的是另一件事:数学是一门靠「人类传承链」延续的学科,如果一个想法的归属成了算力竞速的副产品,愿意接手发展这些思想的年轻数学家就会越来越少——AI 构想出的想法,永远活不成数学正典的一部分。
陶哲轩此前已警告过,这种竞速式介入会改变开放科研的传统。
把几条线索放在一起,你能看到这场争执真正的新鲜之处。过去,「你的数据会被用于改进模型」是一行用户协议里的小字;现在,它成了顶尖数学家怀疑自己的研究草稿变成了竞争对手「解题思路」的理由。用 AI 工具做研究的数学家,恰好是在给 AI 公司递交最优质的数据——这像不像一个循环?
OpenAI 没有作弊实锤,目前的指控多数停留在怀疑层面。但规则真空是真实存在的:学术优先权按论文提交时间算,而算力公司可以按信息到达的时间启动竞速——两套时钟对不上,摩擦只会越来越多。
下次你往 Codex 或者任何 AI 工具里粘贴自己的工作成果时,不妨想想这 88 小时:你的输入可能不会泄露,但它或许正在教一个即将和你竞赛的模型。
至于数学界 90 年没解出的题,AI 用 88 小时交了卷——顺便把「到底是谁先做的」这道题留给了人类。后一道题没有 Lean 验证,只有联名信。