DeepSeek 的 Flash 追上了 Pro,然后 Pro 就没了
昨晚十一点,不少开发者的群里同时弹出一张 DeepSeek 开放平台的公告截图。有人回了一句:「我的 Pro 呢?」
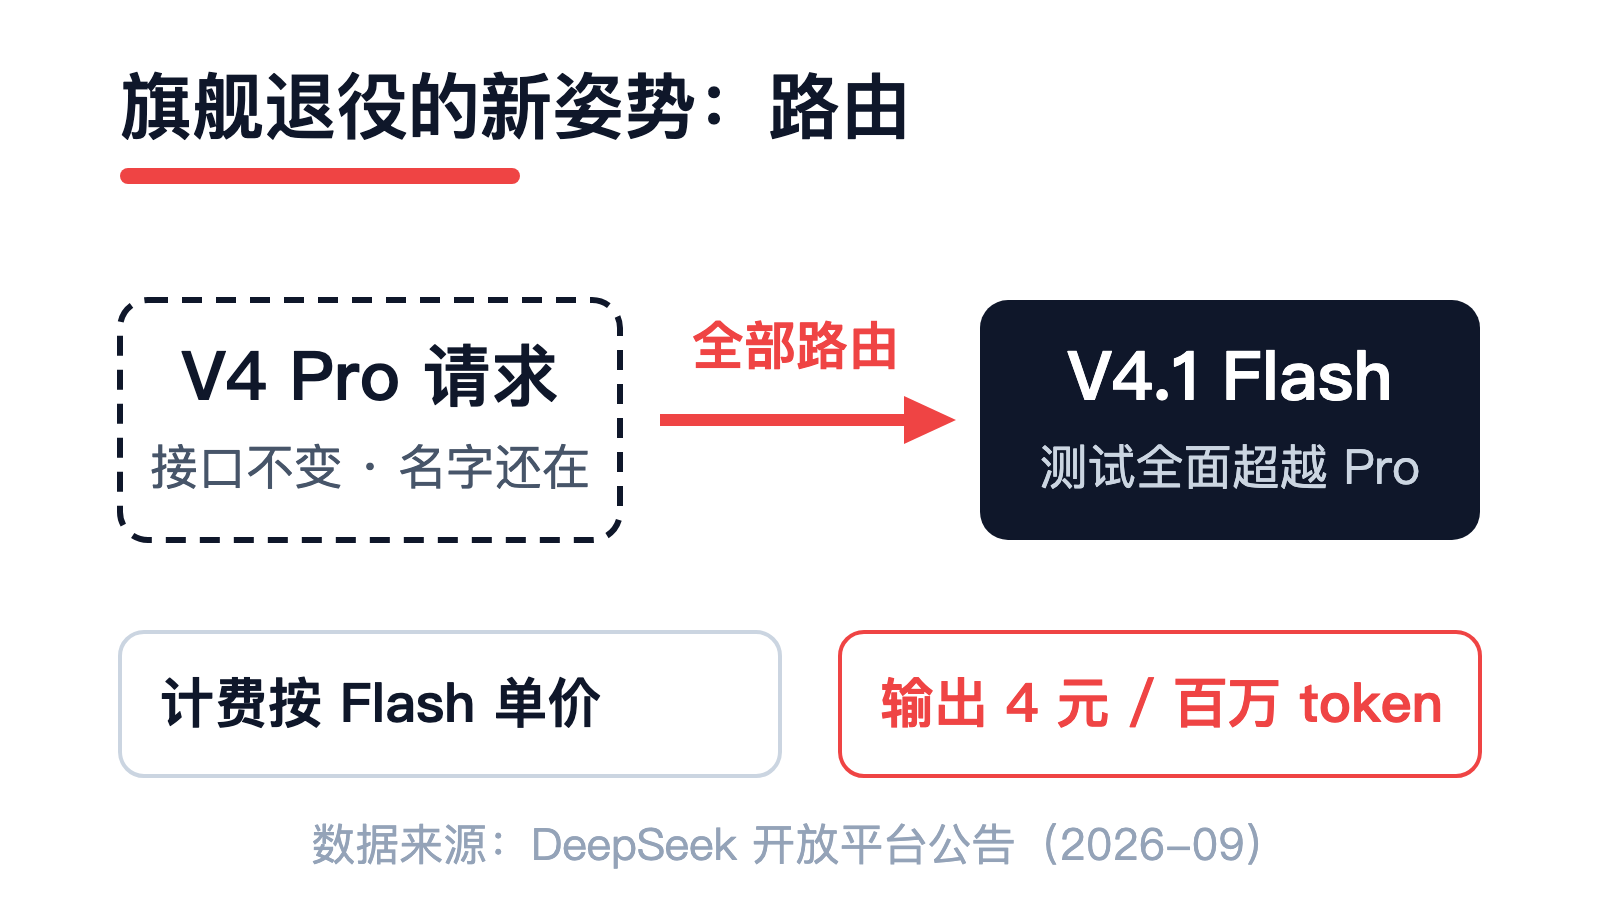
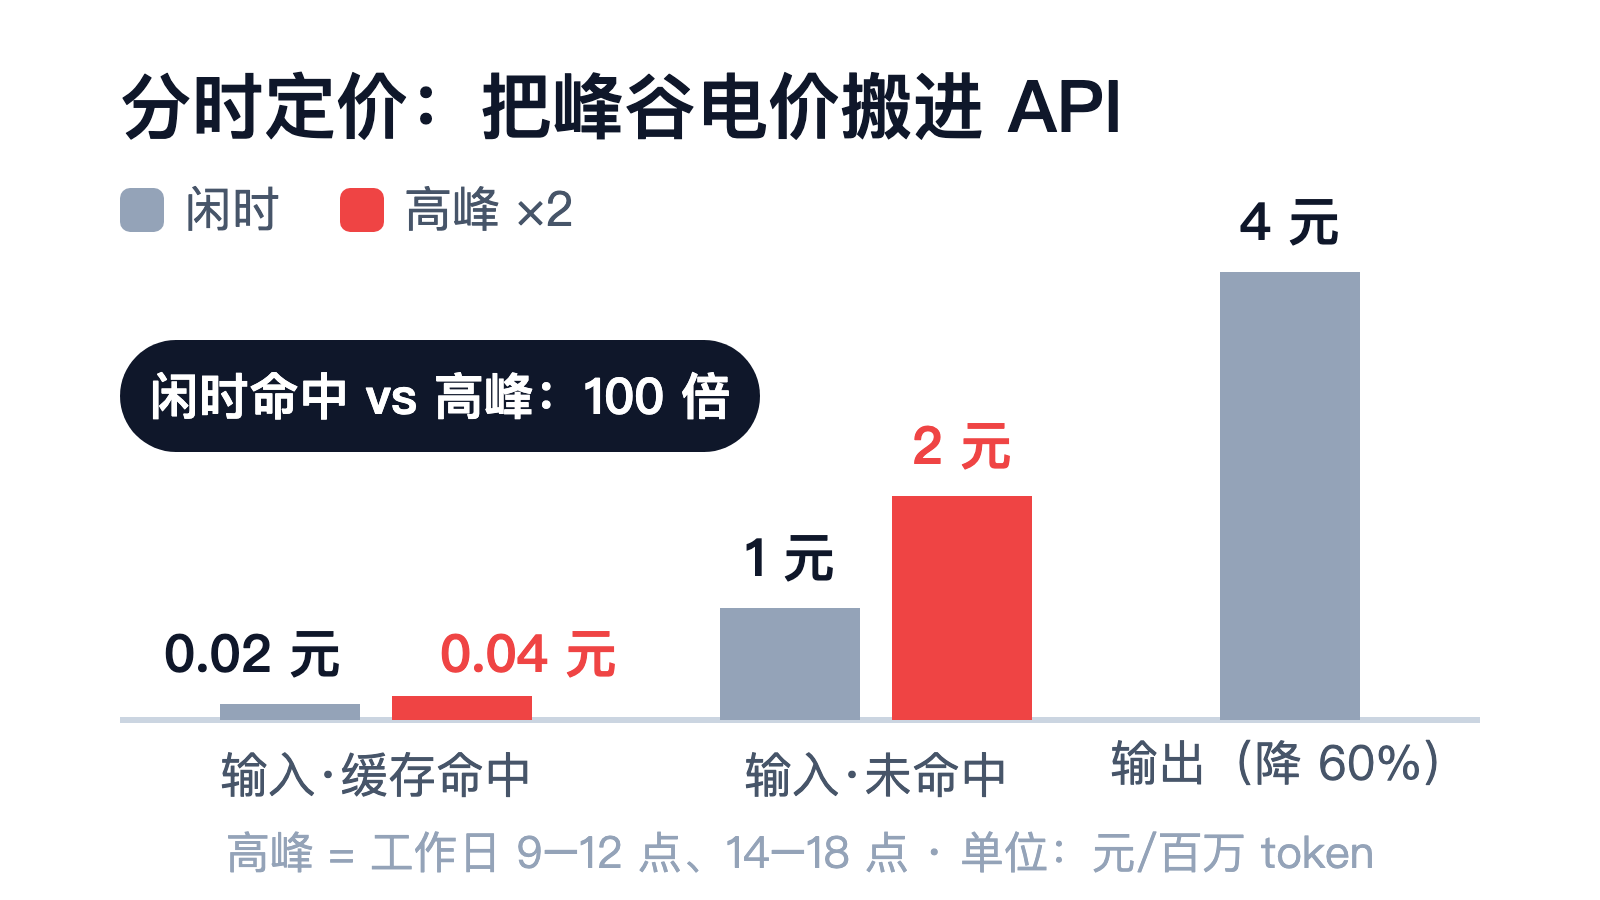
事情分两层。第一层是降价:V4-Flash 系列的 API 定价调整,9 月 10 日中午 12 点生效——每百万 token 的输出价格降到 4 元,输入闲时缓存命中只要 0.02 元、未命中 1 元,高峰时段按两倍计。官方口径里,「输出价最高降 60%」。第二层更狠:据 DeepSeek 官网消息,新模型 V4.1 Flash 即将上线,内部和外部多方测试显示,它在性能、费用、速度、总用时上全面超越 V4 Pro;而在 V4.1 Pro 出来之前,所有发给 V4 Pro 的请求会被直接路由到 V4.1 Flash,按 Flash 的单价计费。
翻译成人话:小杯变成了大杯,大杯自己退场了。
大模型的产品分层,行业里一直有一套标准剧本。旗舰 Pro 定高价,是能力的锚,也是利润的锚;Flash/mini 这类小杯负责走量,用打折的能力换低价市场。两档之间永远隔着一道「你多花的钱买了什么」的护城河。DeepSeek 把这道河填了——不是让 Pro 更强,而是让 Flash 强到追平 Pro,然后让所有 Pro 流量「顺路」流进 Flash 的价签里。用户没有感知断档,账单却先降了。
这个手法比直接降价高明的地方在于「路由」二字。公告里没有一个「下架」或「停售」,V4 Pro 的名字还在、接口还在,你的代码一行都不用改——变的只是机房里那层看不见的调度。产品线退役通常是一场公关事故:老用户被抛下,新用户观望。而路由让这次退役静悄悄发生,价格信号只出现在月底的账单上。
更值得琢磨的是分时定价这张表。闲时输入缓存命中 0.02 元,高峰时段两倍——高峰被明确定义为工作日的上午 9 点到 12 点、下午 2 点到 6 点。这个结构你很熟悉:峰谷电价。过去两年大家讨论算力,说它是新的电力,多半是修辞;现在 DeepSeek 把电力行业的定价表原样搬进了 API。对开发者的实际含义是:批处理、离线评估、索引构建这类不赶时间的任务,挪到夜里跑,输入成本最多能差出几十倍——0.02 元对高峰未命中的 2 元,是一百倍的价差。
分时定价还有一层信号:模型公司开始像运营电网一样运营推理集群了。白天算力被真人聊天和实时任务挤满,夜里机器空转——与其浪费,不如打个一折卖给「不着急」的任务。这不是让利,是填谷。当定价表精细到这个程度,说明推理成本的压力已经大到值得用一个新计费维度去对冲。
有人会算账:8 月 17 日那次涨价,输出价格翻了一倍;这次降 60%,输出 4 元,恰好还是涨价前的两倍。输入倒是回到了涨价前的水平。也就是说,这轮「大降价」更像一次精调:把输入价格打回去抢开发者,把输出价格维持在一个有利可图的位置,再用新模型接管旗舰流量。降价的新闻感是给市场看的,账单的精细度是给财务算的。
当然要补一句口径:所谓「全面超越 V4 Pro」,出自 DeepSeek 官网消息及「内外部多方测试」,不是第三方基准榜单的结论,最终成色要看上线后大家跑出来的真实数据。但方向本身已经够说明问题——官方自己都懒得为 Pro 辩护了。
对我们这些普通用户,这条新闻的传导链其实很短:你用的 AI 应用,模型成本早就被摊薄到每句话几厘钱,降价短期内不会让会员费打折。真正被改写的是开发者的选型逻辑——当「最能打的模型」顶着最便宜的档位名号上线,「哪个模型最强」就不再是个好问题,「哪个模型便宜得够用」才是。大模型竞争打到这里,比的不是谁最强,而是谁最强得最便宜。旗舰不再靠能力卖钱,只靠能力留名;赚钱这件事,交给了规模化推理的效率。
不过我保留一个判断:多数开发者的总账单不会因为这次降价变薄——省下来的钱,大概率会变成十倍的调用量。你会怎么选:账单说了算,谁便宜够用谁上?还是认准一家头部省心?或者按任务切换,写代码用一个、闲聊用另一个?