功耗砍半还跑赢英伟达:OpenAI 首颗自研芯片,凭什么?
8 月 25 日 Hot Chips 2026,OpenAI 硬件负责人 Richard Ho 第一次把代号 Jalapeño 的自研推理芯片摆到公开跑分榜上。在 SemiAnalysis 的 InferenceX 基准下,"每用户 token 数"和"每千瓦吞吐量"两项关键指标,双杀了英伟达当下的旗舰 GB200/GB300 系统——而且只用了一半的功耗。
三个数字,把差距说清楚
跑分用 SemiAnalysis 的 InferenceX 公开基准,测了 GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1T 三款模型。
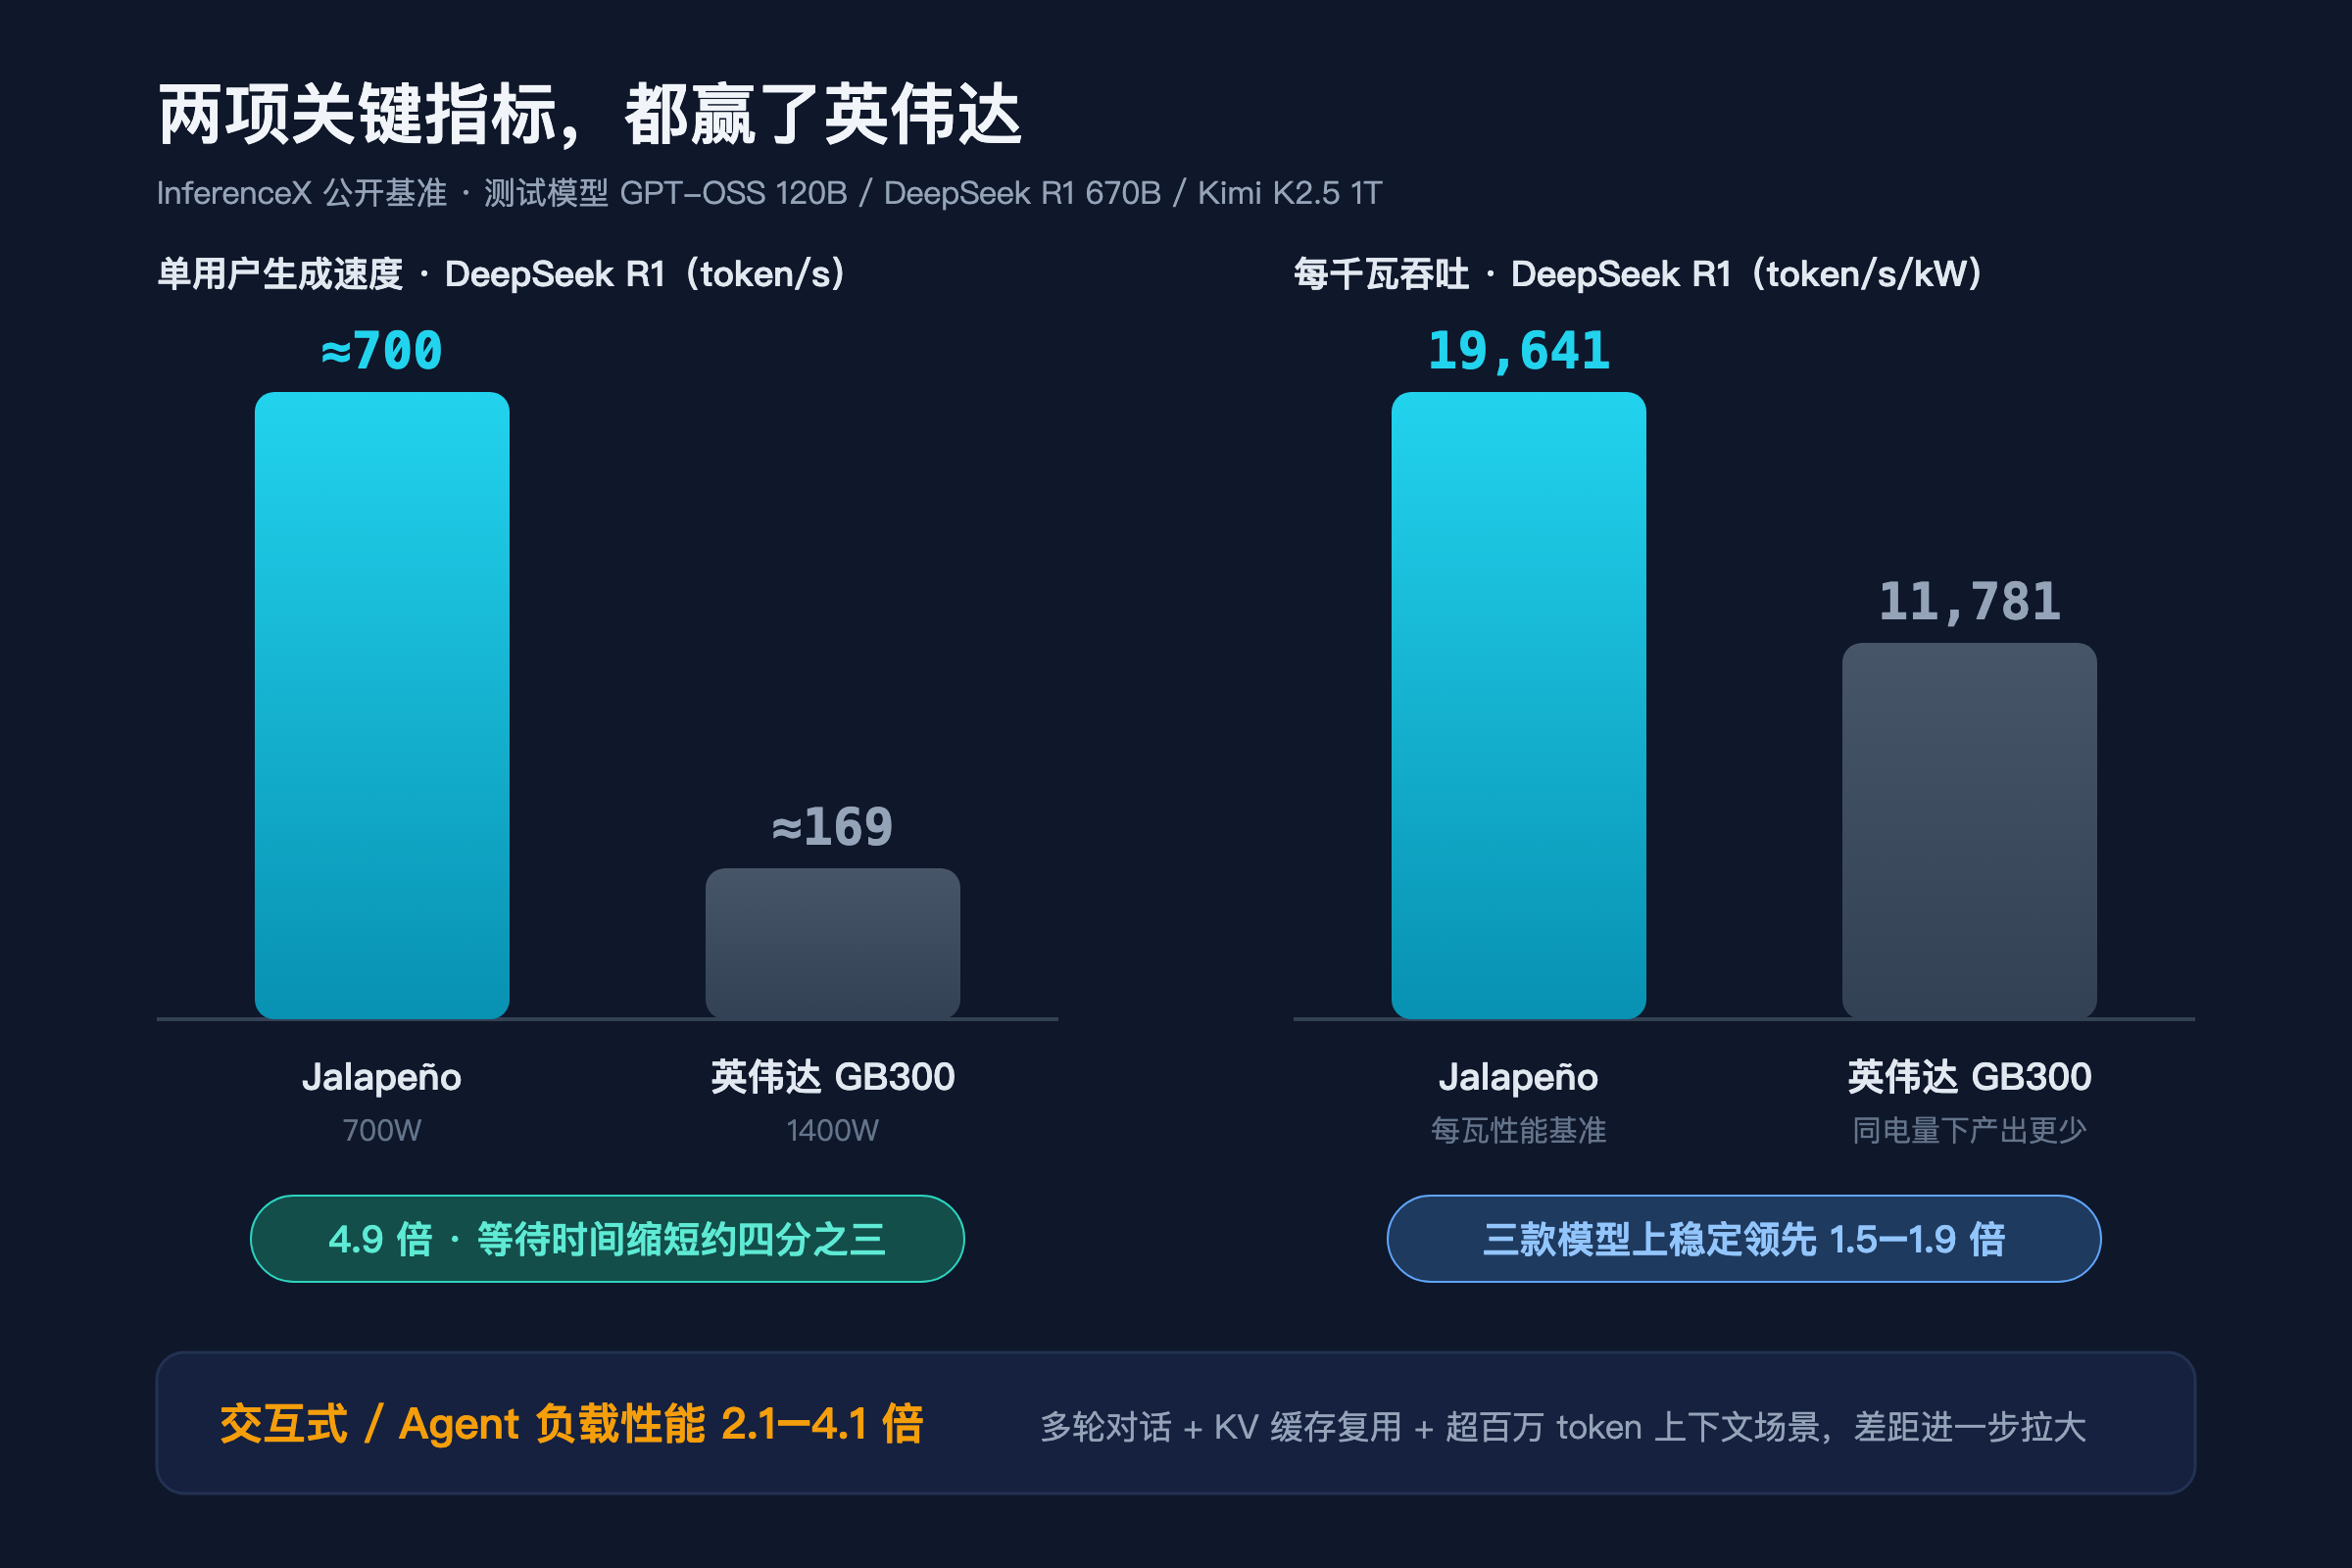
- 每千瓦吞吐 1.5–1.9 倍:Jalapeño 用同样电量多干近一倍的活。
- DeepSeek R1 单用户 4.9 倍:低延迟场景下,Jalapeño 约 700 token/s,GB300 只有 169 token/s。
- 交互式/Agent 负载 2.1–4.1 倍:多轮对话、KV 缓存复用、百万级上下文场景,差距更大。
一半的功耗
700W vs 1400W。Jalapeño 用台积电 3nm + 6 组 HBM4(216 GiB 显存、15.4 TB/s 带宽),架构上做了 64 组"内存/核心"成对切片,KV 缓存强制留在本地,避免跨片反复搬运。
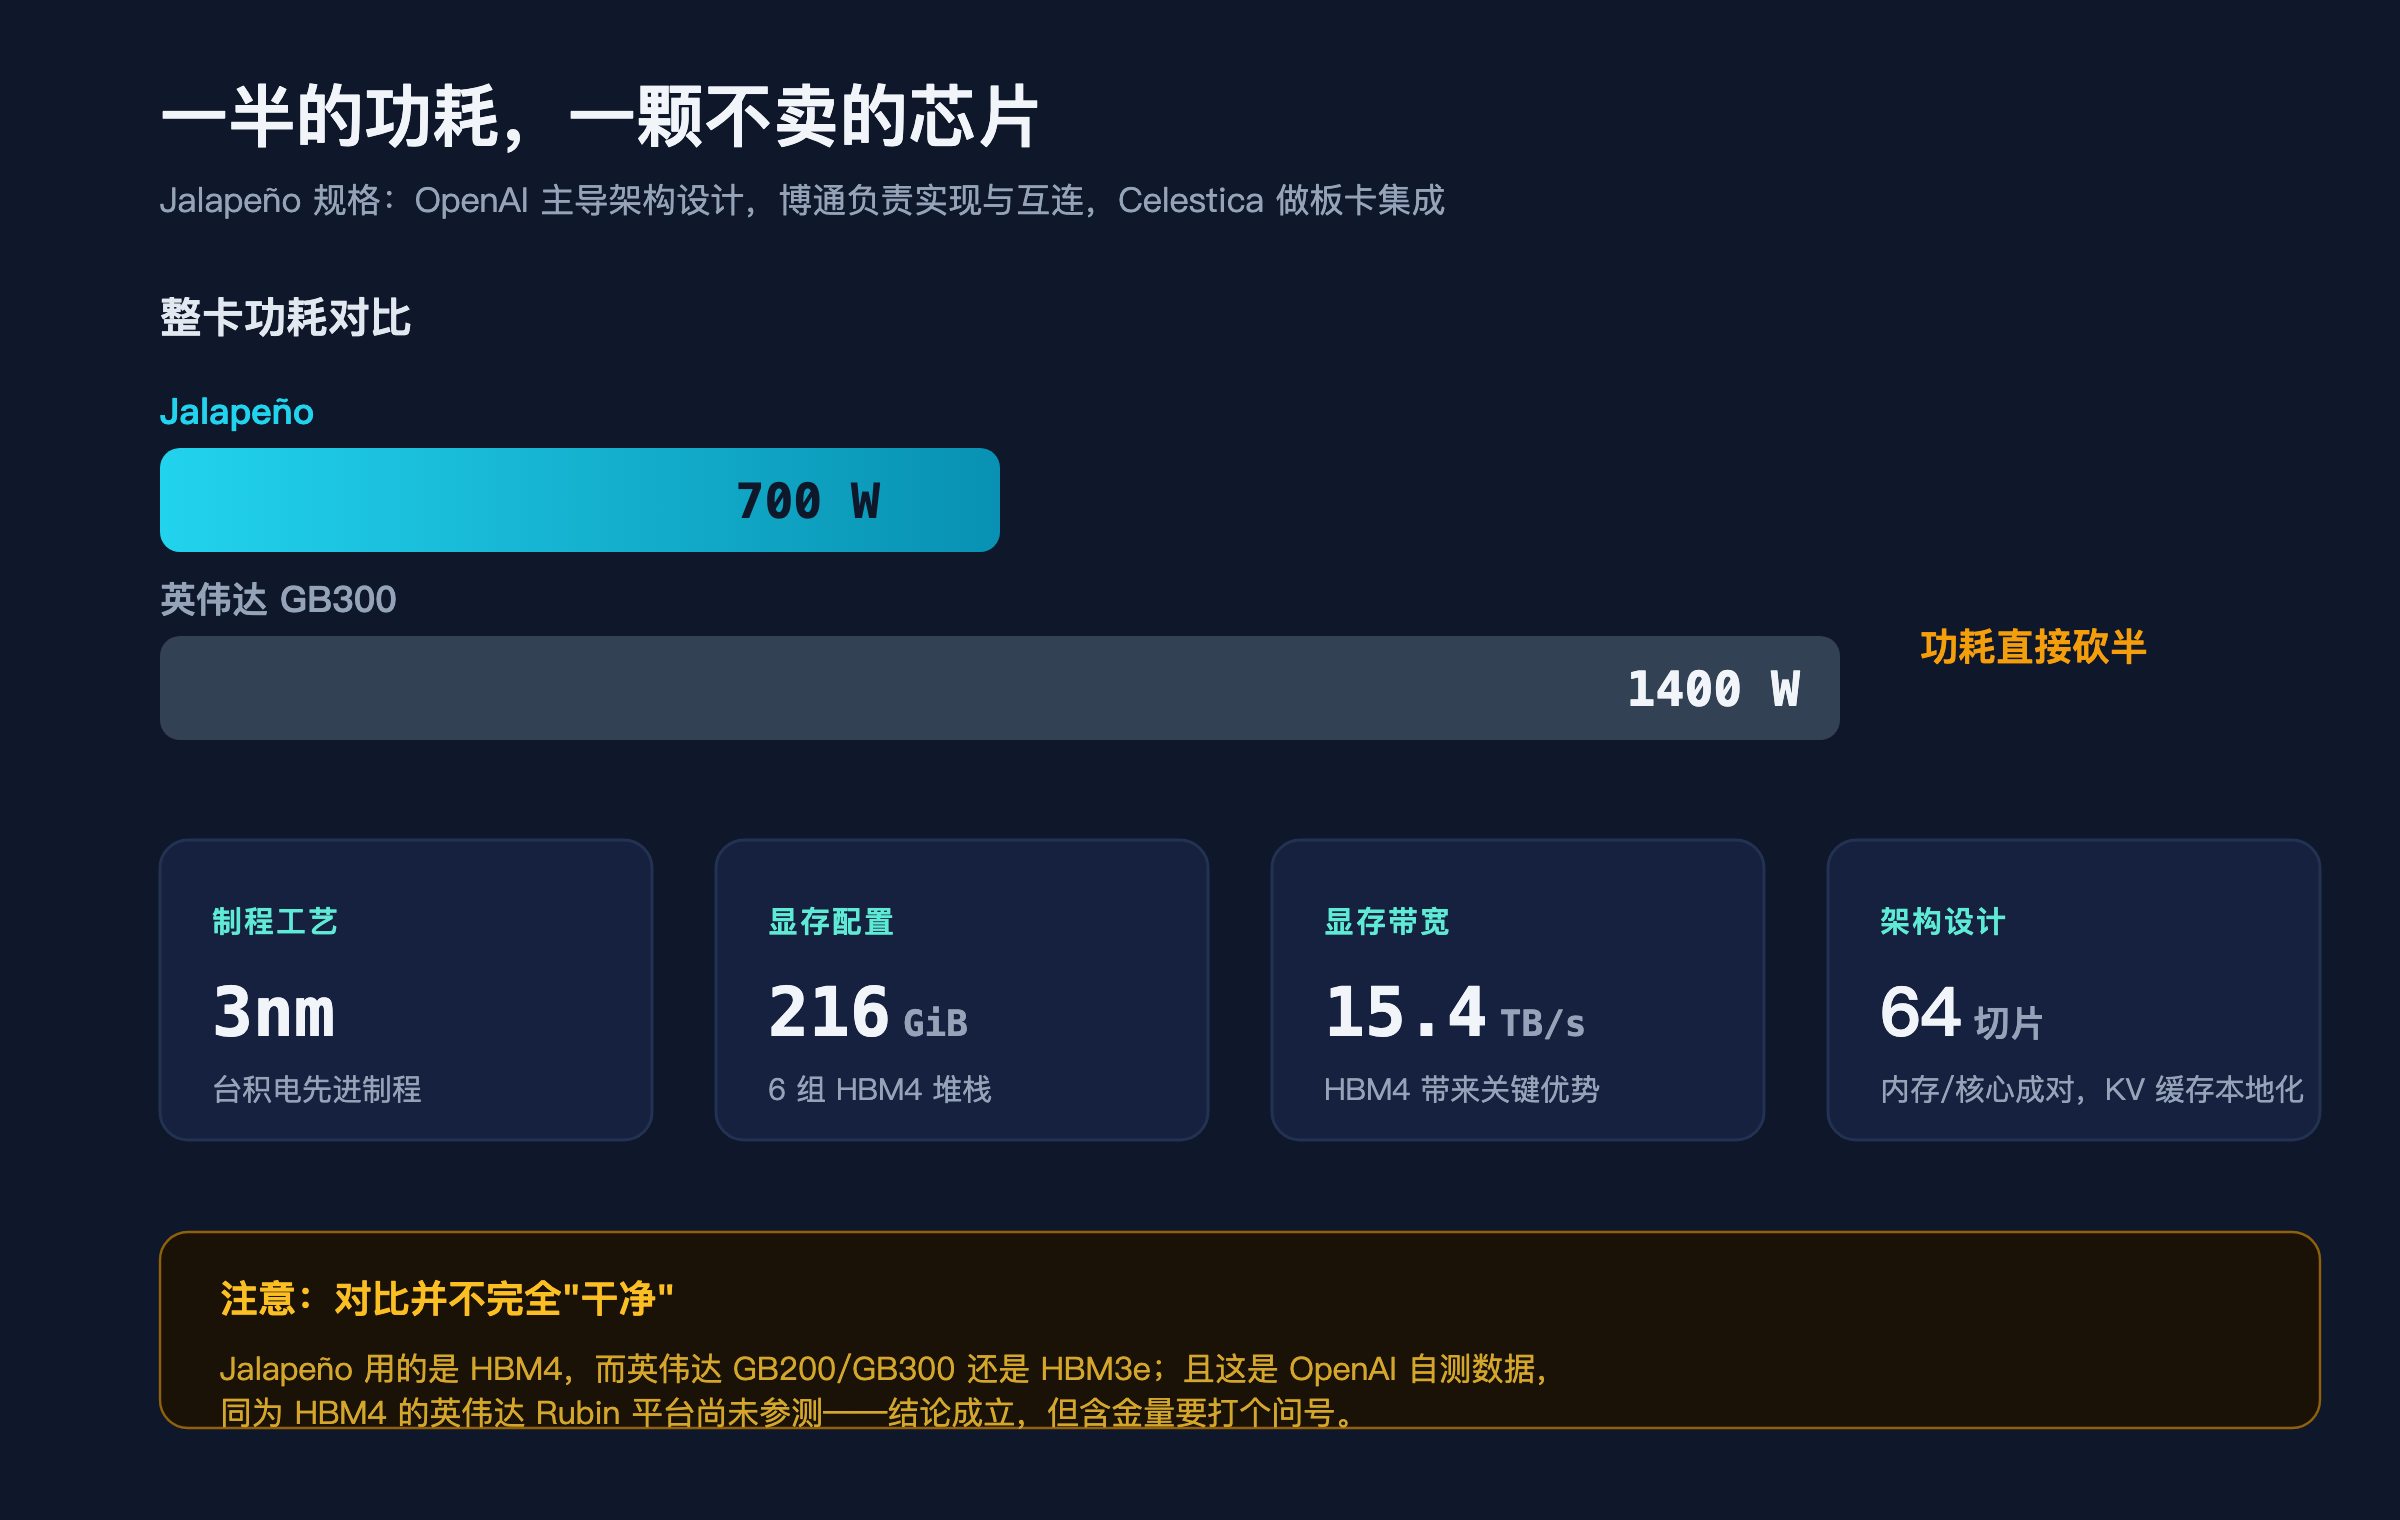
不过别急着喊"英伟达要输"——Jalapeño 是 HBM4,GB200/GB300 还停在 HBM3e;跑分也是 OpenAI 自家做的。真正同代的对手是同样配 HBM4 的英伟达 Rubin,俩还没交过手。
9 个月流片,AI 写了一多半代码
更让人在意的,是它"被造出来的速度"——行业常规流片 18–24 个月,Jalapeño 不到一半。
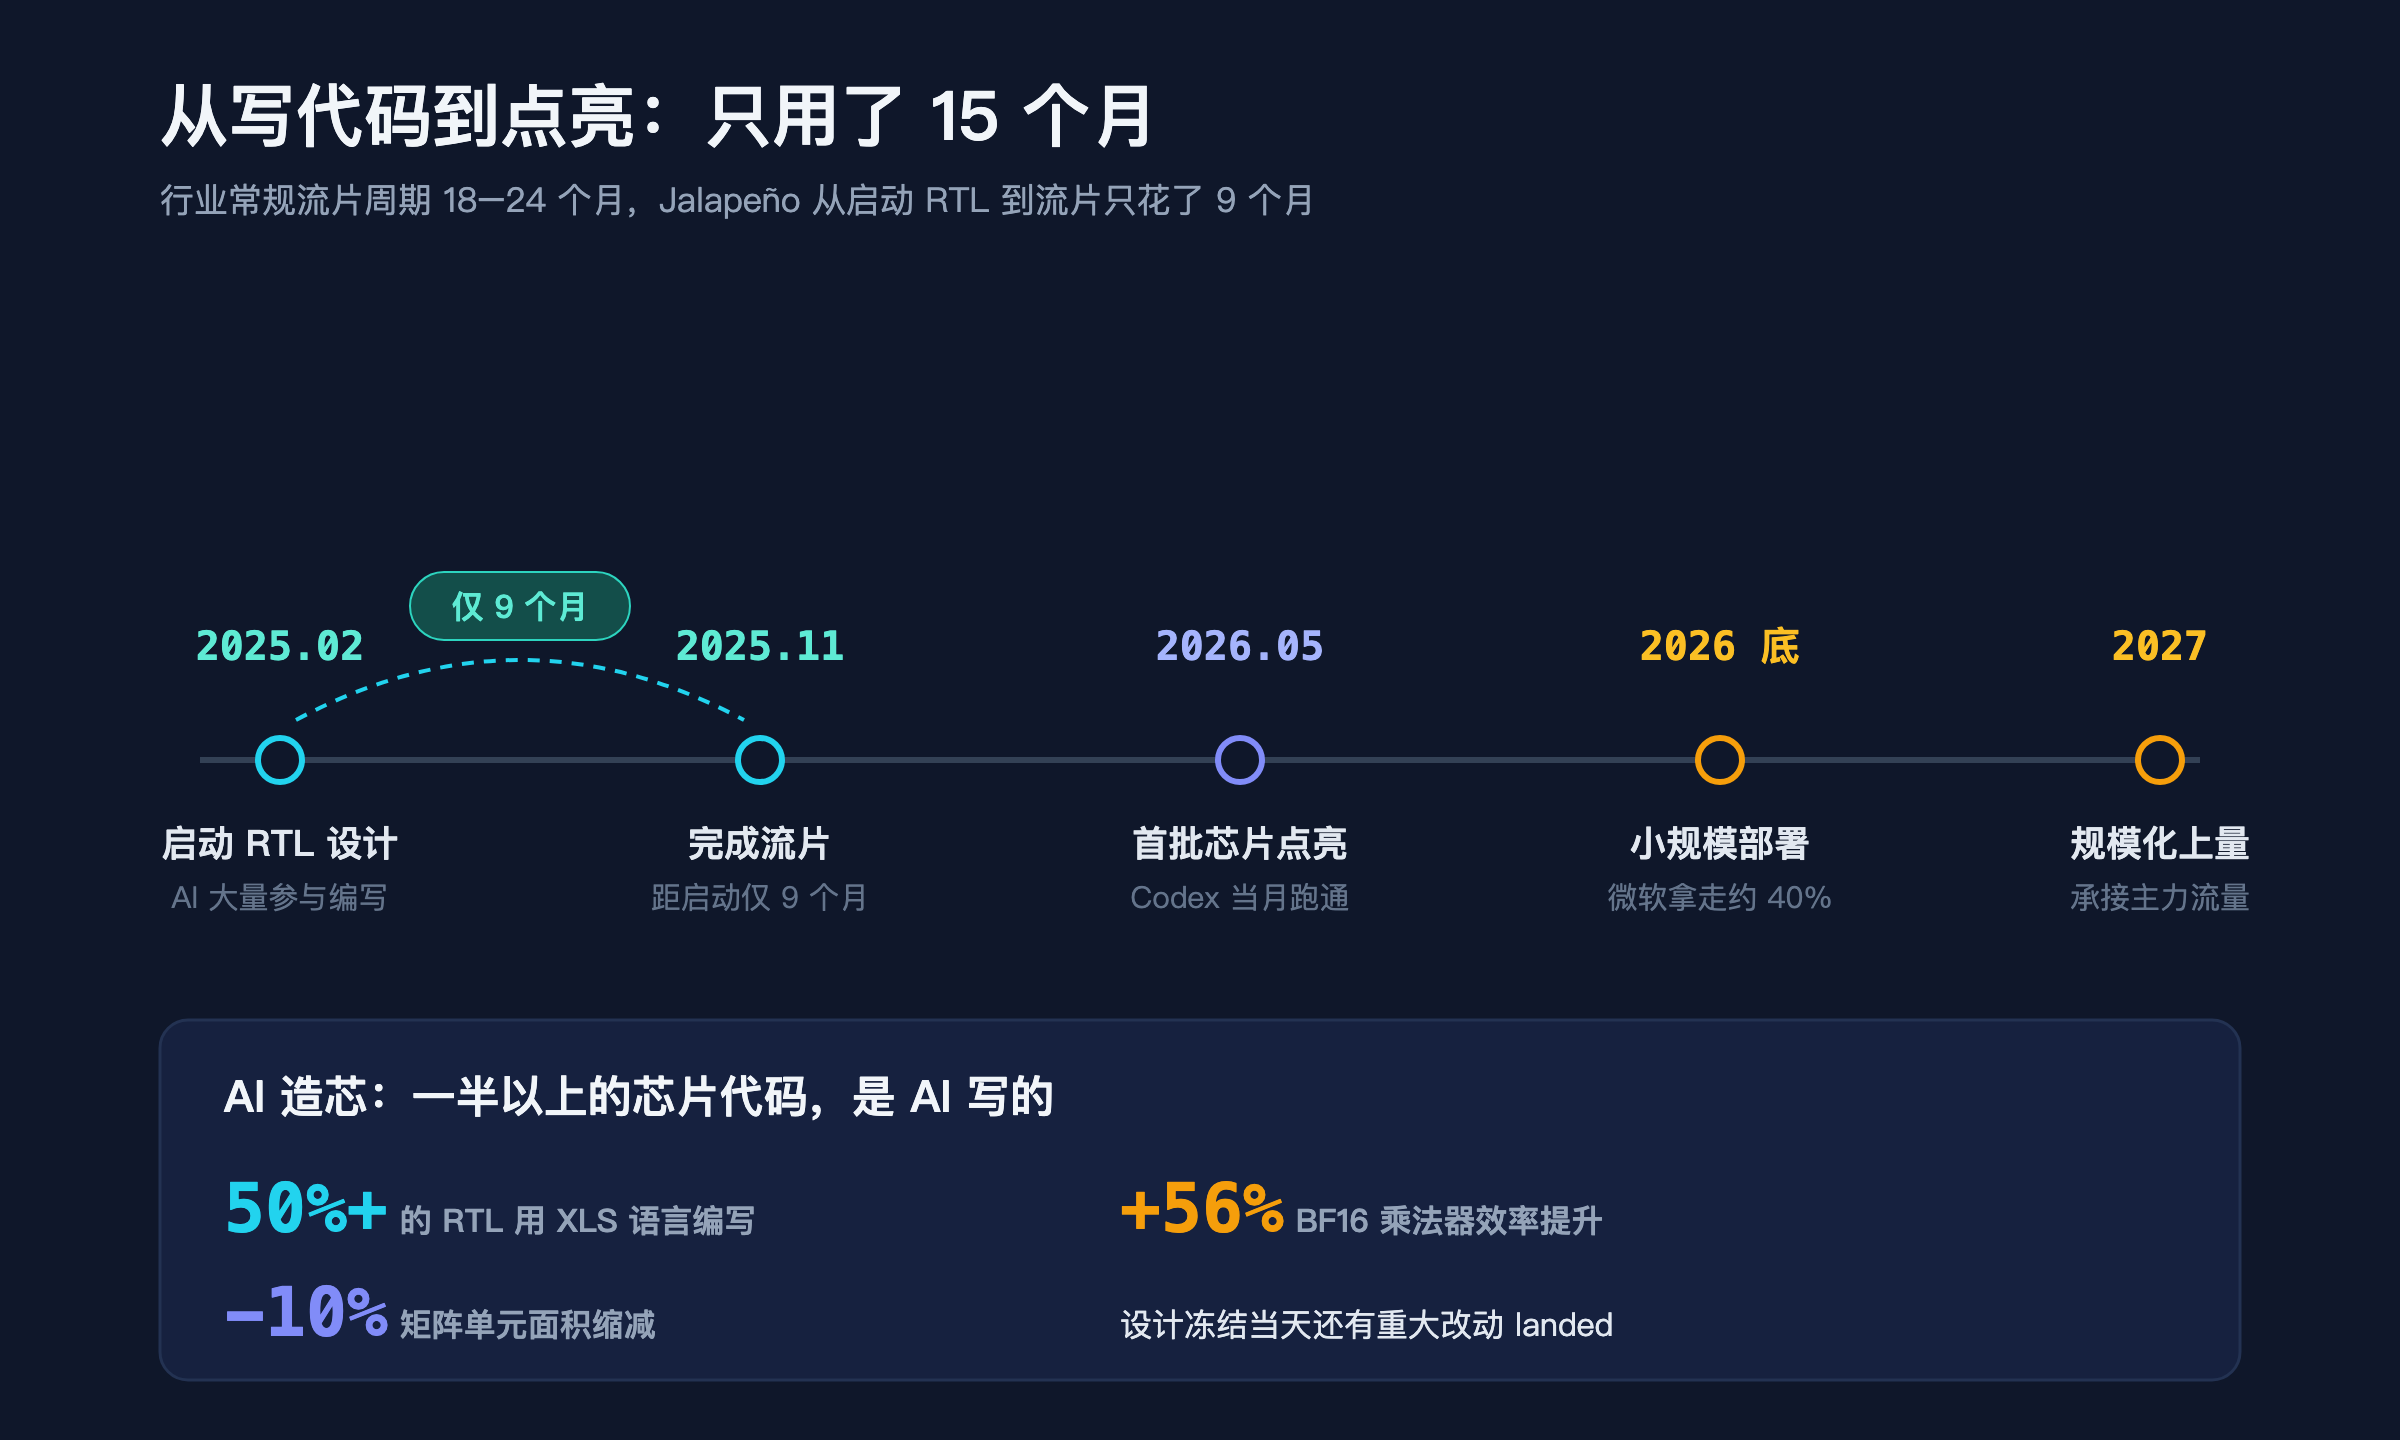
- 2025.02 启动 RTL 设计
- 2025.11 完成流片,距启动仅 9 个月
- 2026.05 首批芯片点亮,Codex 当月跑通
- 2026 年底极小规模部署,微软先拿走约 40%
- 2027 规模化上量,承接主力 API 流量
加速的核心原因之一,是 AI 深度参与设计。超一半 RTL 用 Google 开源的 XLS 编写,OpenAI 自家模型在搜索"功耗 / 性能 / 面积"最优组合——BF16 乘法器效率 +56%,矩阵单元面积 −10%。
真正的大新闻,是"秩序"反过来了
过去二十年,行业默认节奏是:英伟达发布什么,大家适配什么。 Jalapeño 把顺序倒过来——先有模型,再反向设计最合适的芯片,硬件围着模型转。
这颗芯片不会对外出售,也不会以云实例开放,OpenAI 内部产能都不够分。中长期它会改变一件更基础的事:OpenAI 的 API 定价、长上下文成本、Agent 延迟,都可能被这颗 700W 的芯片重新洗一遍。 决赛要等 2027:Rubin、MI400、TPU、Trainium、MTIA 全员下场。
你看好 OpenAI 这颗自研芯片吗?英伟达会被撬动,还是只是"自家用用"?评论区聊聊👇
觉得有用,转发给身边做 AI 产品的朋友一起看。
参考来源
- OpenAI's Jalapeño chip is built for fast inference at scale, benchmarks show(TechCrunch) — https://techcrunch.com/2026/08/25/openais-jalapeno-chip-is-built-for-fast-inference-at-scale-benchmarks-show
- OpenAI's 700W Jalapeño ASIC outpaces 1,400W Nvidia flagship GPU(Tom's Hardware) — https://www.tomshardware.com/tech-industry/semiconductors/openai-says-its-jalapeno-chip-beats-nvidias-gb300-in-first-published-benchmarks
- OpenAI Jalapeno Custom AI ASIC at Hot Chips 2026(ServeTheHome) — https://www.servethehome.com/openai-jalapeno-asic-at-hot-chips-2026/
- OpenAI's Jalapeño Chip Benchmarks: What Developers Need to Know(byteiota) — https://byteiota.com/openai-jalapeno-chip-benchmarks-developer-guide